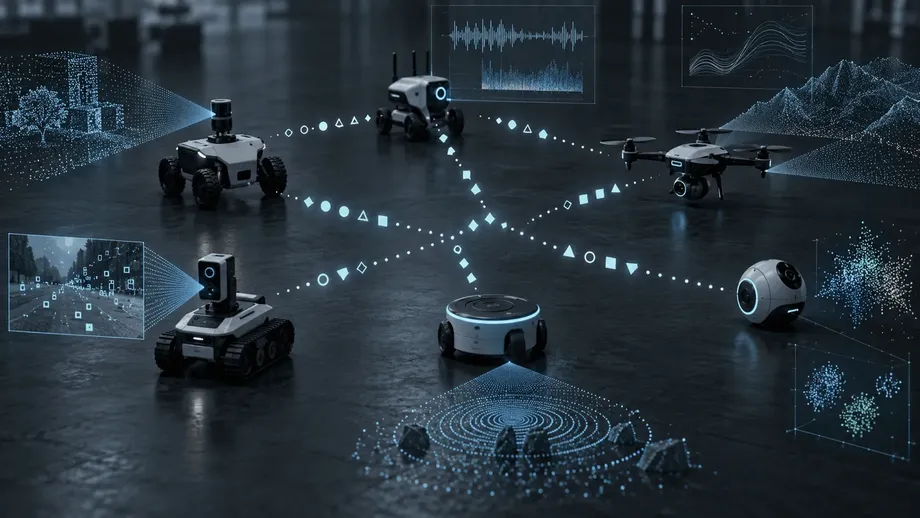
ஒரு மில்லியன் பரிமாற்றங்கள், உருவாக்கிய சொற்களைப் பகிரப்பட்ட பொருளாக மாற்றுகின்றன
காலியான சொற்களஞ்சியத்துடன் தொடங்கிய பத்து செயற்கை நுண்ணறிவு முகவர்கள், பெல்ஜியத்தில் உள்ள வ்ரிஜே யுனிவர்சிட்டெய்ட் பிரஸ்ஸல் (VUB) மற்றும் நமூர் பல்கலைக்கழக ஆராய்ச்சியாளர்கள் நடத்திய பரிசோதனைகளில், ஒரு மில்லியன் பரிமாற்றங்களுக்குப் பிறகு பொருட்களை ஒன்றுக்கொன்று அடையாளம் காண்பதில் 99.76% வரை வெற்றி பெற்றன. அவற்றின் சொற்களும் பொருள்களும் மனிதர்கள் எழுதிய அகராதி வழியாக அல்லாமல், மீண்டும் மீண்டும் நடந்த பரிமாற்றங்கள் மூலம் உருவாயின.
உள்ளடக்கம்
- ஒரு மில்லியன் பரிமாற்றங்கள், உருவாக்கிய சொற்களைப் பகிரப்பட்ட பொருளாக மாற்றுகின்றன
- ஒரு சொல் எப்படிப் பயனுள்ளதாகிறது
- பொருள் என முகவர்கள் சேமிப்பது என்ன
- பகிரப்பட்ட சொற்களஞ்சியங்கள் எந்த அளவுக்குச் சிறப்பாகச் செயல்பட்டன?
- வெவ்வேறு உணரிகளுடனும் ஒருமித்த கருத்தை உருவாக்க முடியும்
- உள்ளீடுகள் மறையும்போது மாறும் சொற்களஞ்சியம்
- பெரிய குழுக்களுக்கு அதிகப் பரிமாற்றங்கள் தேவை
- ஒரு சொல் எதைக் குறிக்கிறது என்பதை மனிதர்கள் ஆய்வு செய்யலாம்
- வெளியீடு, ஒத்துழைப்பு மற்றும் சாத்தியமான பயன்பாடுகள்
- முக்கிய அம்சங்கள்
மது பற்றிய வேதியியல் அளவீடுகள், நாசாவின் புறக்கோள் தரவுகள் முதல் பறவைகள் மற்றும் மனித முகங்களின் புகைப்படங்கள் வரை உள்ள 37 பொதுத் தரவுத்தொகுப்புகளில் ஆராய்ச்சியாளர்கள் தங்கள் முறையைச் சோதித்தனர். முக்கியமாகக் குறிப்பிடப்பட்ட ஏழு தரவுத்தொகுப்புகளில், சோதனைப் பரிமாற்றங்களின் வெற்றி 95.77% முதல் 99.76% வரை இருந்தது.
விஷயங்களைக் குறிப்பிடுவது எப்படி என்பதில் ஒருமித்த கருத்தை உருவாக்கியதே இந்தச் சாதனையின் மையமாகும். ஒவ்வொரு முகவரும் உருவாக்கிய சொற்களுக்கும் தான் கவனித்த பண்புகளுக்கும் இடையிலான தொடர்புகளைத் தனித்தனியாகச் சேமித்தது. பின்னூட்டத்தின் மூலம், உறுப்பினர்கள் தங்கள் சூழலை வெவ்வேறு விதமாக உணர்ந்தபோதும், அந்தத் தனிப்பட்ட தொடர்புகள் குழு தொடர்புகொள்ளும் அளவுக்கு ஒத்துப்போயின.
ஆராய்ச்சிக் கட்டுரை கணினி உருவகப்படுத்தலில் நடத்தப்பட்ட பரிசோதனைகளை விவரிக்கிறது. அதன் தலைப்பு: தொடர்ச்சியான உலகங்களில் தன்னிச்சையாக உருவாகும் தொடர்பாடல்: கருத்தியல் அடிப்படையிலான சொற்களஞ்சியங்களைப் பெரிய அளவில் சுயமாக ஒழுங்கமைத்தல். முகவர்கள் பொருட்கள் மற்றும் படங்களின் எண் வடிவங்களுடன் செயல்பட்டன. இந்த அணுகுமுறைக்கான சாத்தியமான பயன்பாடுகளாக ரோபோக்கள், தன்னாட்சி வாகனங்கள் மற்றும் தொழில்துறை உணரிகள் ஆகியவற்றை ஆராய்ச்சியாளர்கள் அடையாளம் கண்டுள்ளனர்.
ஒரு சொல் எப்படிப் பயனுள்ளதாகிறது
ஒவ்வொரு பரிமாற்றத்திலும் இரண்டு முகவர்கள் பங்கேற்கின்றன. ஒன்றுப் பேசுபவராகவும் மற்றொன்று கேட்பவராகவும் இருக்கும்; பரிமாற்றங்கள் தொடரும்போது இந்தப் பாத்திரங்கள் புதிதாக ஒதுக்கப்படும். இரண்டும் பல பொருட்கள் உள்ள ஒரு காட்சியை எதிர்கொள்கின்றன; ஆனால் இலக்குப் பொருள் எது என்று பேசுபவருக்கு மட்டுமே தெரிவிக்கப்படும்.
கேட்பவர் அந்த இலக்கைத் தேர்ந்தெடுக்க உதவும் ஒரு சொல்லைப் பேசுபவர் தேர்ந்தெடுக்க வேண்டும். அதன் சொற்களஞ்சியத்தில் பொருத்தமான சொல் இல்லையென்றால், அது ஒன்றை உருவாக்கும். "demoxu" போன்ற மூன்று அசைகளைக் கொண்ட எந்தவிதப் பொருளும் உள்ளடங்காத எழுத்துக்கோவைகளை இந்தக் கட்டுரை பயன்படுத்துகிறது; எனவே அந்தச் சொல்லுக்கு உள்ளார்ந்த பொருள் எதுவும் இல்லை.
கேட்பவர் அந்தச் சொல்லைத் தன்னிடம் சேமிக்கப்பட்டுள்ள கருத்துகளுடன் ஒப்பிட்டு, ஒரு பொருளைத் தேர்ந்தெடுக்கும். தேர்வு சரியா என்பது குறித்த பின்னூட்டம் இரு முகவர்களுக்கும் கிடைக்கும். தேர்வு தவறினால், இலக்குப் பொருள் கேட்பவருக்குக் காட்டப்படும்; இதன் மூலம் அது தனது புரிதலைத் திருத்திக் கொள்ளத் தகவல் பெறுகிறது.
சொற்களை உருவாக்குதல், கருத்துகளைப் பிரதிநிதித்துவப்படுத்துதல், முடிவுகளிலிருந்து கற்றுக்கொள்ளுதல் ஆகியவற்றுக்கான செயல்முறைகளை ஆராய்ச்சியாளர்கள் வழங்கினர். குறிப்பிட்ட சொற்களஞ்சியமும் அதனுடன் இணைக்கப்பட்ட வகைகளும் தொடர்பாடலின்போது உருவாயின. வெற்றிகரமான பரிமாற்றங்கள் பயனுள்ள தொடர்புகளை வலுப்படுத்துகின்றன; அடுத்தடுத்த அனுபவங்கள் சொற்களுடன் இணைக்கப்பட்ட கருத்துகளைச் சரிசெய்கின்றன.
நமூர் பல்கலைக்கழகப் பேராசிரியரும் இணை ஆசிரியருமான Katrien Beuls, உள்ளூர்மட்டப் பரிமாற்றங்கள் ஒரு மக்கள் குழு முழுவதும் எப்படி ஒருமித்த கருத்தை உருவாக்குகின்றன என்பதை பல்கலைக்கழக அறிவிப்பில் விளக்கினார்:
இதில் வியப்பூட்டுவது, விதிகளைத் திணிக்கும் மையக் கணினி எதுவும் இல்லை என்பதுதான். ஒவ்வொரு முறையும், இரு முகவர்கள் உள்ளூர்மட்டத்தில் ஒன்றுடன் ஒன்று தொடர்புகொள்ள அனுமதிக்கிறோம். இந்தத் தனிப்பட்ட பரிமாற்றங்களும் புதுப்பிப்புகளும் மட்டுமே, முழு மக்கள் குழுவிலும் ஒரு பொதுவான வழக்கம் தன்னிச்சையாக உருவாகக் காரணமாகின்றன.
பொருள் என முகவர்கள் சேமிப்பது என்ன
ஒவ்வொரு பொருளும் ஒரு பண்புக் திசையன் வடிவில் முகவரைச் சென்றடைகிறது; அதாவது, அதன் பண்புகளை விவரிக்கும் மதிப்புகளின் பட்டியல். எடுத்துக்காட்டாக, ஒரு மது மாதிரியை வேதியியல் அளவீடுகள் மூலம் பிரதிநிதித்துவப்படுத்தலாம். ஒரு படத்தை, பார்வை அமைப்பு பிரித்தெடுக்கும் எண் பண்புகள் மூலம் பிரதிநிதித்துவப்படுத்தலாம்.
ஒரு சொல், கருத்து முன்மாதிரியுடன் இணைக்கப்படுகிறது: அந்தச் சொல் பொருந்தக்கூடிய கவனிப்புகளின் வகைகளை விவரிக்கும் கணித வடிவம் அது. வழக்கமான மதிப்புகள், அவற்றில் உள்ள மாறுபாட்டின் அளவு, மிக முக்கியமான பண்புகள் ஆகியவற்றை இந்த முன்மாதிரி பதிவு செய்கிறது. புதிதாகச் சந்திக்கும் பொருள், ஏற்கெனவே பழக்கமான சொல்லுடன் எந்த அளவுக்குப் பொருந்துகிறது என முகவர் மதிப்பிட இது உதவுகிறது.
சூழலும் முக்கியம். காட்சியில் உள்ள மற்ற பொருட்களைவிட இலக்குப் பொருளுடன் சிறப்பாகப் பொருந்தும் கருத்தைக் கொண்ட சொல்லை பேசுபவர் தேடுகிறது. எனவே, எல்லாப் பொருட்களுக்கும் நிரந்தரமாக ஒரு பெயரைச் சூட்டுவதற்குப் பதிலாக, உடனடியாகக் கிடைக்கும் மாற்றுப் பொருட்களிலிருந்து ஒன்றை வேறுபடுத்த உதவும் சொல்லே பயனுள்ளதாகும்.
முகவர்கள் இந்தப் பிரதிநிதித்துவங்களைத் தனித்தனியாகச் சேமிக்கின்றன. ஒன்றுக்கொன்று உள்ளக அமைப்புகளையோ மைய அறிவுத் தளத்தையோ அணுக முடியாது. அவற்றின் சொற்கள் ஒத்துப்போகும் தேர்வுகளுக்கு வழிகாட்டுவதால் பகிரப்பட்ட தொடர்பாடல் உருவாகிறது; அதே நேரத்தில், ஒவ்வொரு முகவரின் தனிப்பட்ட பிரதிநிதித்துவங்களும் அதன் சொந்தக் கவனிப்புகளுடன் பிணைந்திருக்கின்றன.
படத் தரவுத்தொகுப்புகளுக்கு, ஏற்கெனவே உள்ள DINOv2 பார்வைக் குறியாக்கியிலிருந்து 384 பரிமாணங்களைக் கொண்ட பண்புகளை ஆராய்ச்சியாளர்கள் பயன்படுத்தினர். ஒரு படத்தை மற்ற மென்பொருள்கள் செயலாக்கக்கூடிய எண் விளக்கமாகப் பார்வைக் குறியாக்கி மாற்றுகிறது. பின்னர், அந்த விளக்கங்களின் அடிப்படையில் சொற்களஞ்சியக் கற்றல் செயல்பட்டது.
பகிரப்பட்ட சொற்களஞ்சியங்கள் எந்த அளவுக்குச் சிறப்பாகச் செயல்பட்டன?
வழக்கமான பரிசோதனைகளில், 10 முகவர்களைக் கொண்ட குழுக்கள் ஒரு மில்லியன் பரிமாற்றங்கள் வழியாகப் பயிற்றுவிக்கப்பட்டன. பின்னர், பயிற்சியிலிருந்து ஒதுக்கி வைக்கப்பட்ட பொருட்களையும் உள்ளடக்கிய 100,000 சோதனைப் பரிமாற்றங்களில் தொடர்பாடல் மதிப்பிடப்பட்டது; 10 தனித்தனி ஓட்டங்களின் முடிவுகள் சராசரியாகக் கணக்கிடப்பட்டன.
முக்கியமாகக் குறிப்பிடப்பட்ட ஏழு முடிவுகள், இந்த முறையின் வலிமையையும் பணிகளுக்கு இடையிலான மாறுபாட்டையும் காட்டுகின்றன:
- CLEVR: காட்சிப் பொருட்களின் பண்புகள் தொடர்பான தரவுத்தொகுப்பு; தொடர்பாடல் வெற்றி 99.76%.
- மது பகுப்பாய்வுத் தரவு: 99.76%.
- புறக்கோள் தரவு: 99.67%.
- காளான் தரவு: 98.10%.
- MS COCO படத் தரவு: 95.77%.
- CelebA முகப் படங்கள்: 96.66%.
- பறவைப் படங்கள்: 95.88%.
கேட்பவர் நோக்கப்பட்ட பொருளை எத்தனை முறை தேர்ந்தெடுத்தார் என்பதையே இந்தச் சதவீதங்கள் அளவிடுகின்றன. மது மற்றும் CLEVR பணிகளுக்கான 99.76% என்பது, ஒவ்வொரு 10,000 சோதனைப் பரிமாற்றங்களிலும் சுமார் 24 பரிமாற்றங்கள் தோல்வியடைந்ததைக் குறிக்கிறது. MS COCO-வின் 95.77% என்பது, ஒவ்வொரு 10,000 பரிமாற்றங்களிலும் சுமார் 423 தோல்விகளைக் குறிக்கிறது.
இந்த முடிவுகளுக்கு இடையிலான வேறுபாடு 3.99 சதவீதப் புள்ளிகள். குறிப்பிடப்பட்ட பணிகள் அனைத்திலும் தொடர்பாடல் வெற்றி உயர்வாக இருந்தது; இருப்பினும், மது மற்றும் புறக்கோள் பணிகளைக் காட்டிலும் இயற்கைப் படத் தரவுத்தொகுப்புகளில் அதிகத் தவறுகள் ஏற்பட்டன.
சொற்களஞ்சியத்தின் அளவையும், முகவர்கள் சொற்களை எவ்வளவு சீராகப் பயன்படுத்துகின்றன என்பதைக் கண்காணிக்கும் பொதுவான வழக்க ஒத்திசைவையும் குழு அளந்தது. இந்த அளவீடுகள் செயல்முறையின் வெவ்வேறு பகுதிகளைப் பற்றியவை: இலக்குகளை நம்பகமாக அடையாளம் காண, ஒரு குழுவுக்குப் பயனுள்ள பெயர்ச்சொற்களின் தொகுப்பும் அவற்றின் பயன்பாடு குறித்த போதிய ஒத்த கருத்தும் தேவை.
வெவ்வேறு உணரிகளுடனும் ஒருமித்த கருத்தை உருவாக்க முடியும்
இயந்திரங்கள் உலகை எப்போதும் ஒரே விதமாகக் கவனிப்பதில்லை. உணரிகளின் அளவுத்திருத்த அமைப்புகள் மாறுபடலாம், அளவீடுகளில் இரைச்சல் இருக்கலாம், ஒரு சாதனம் கண்டறியும் பண்பை மற்றொன்று கண்டறிய முடியாமல் போகலாம். இத்தகைய நிலைமாற்றங்களை ஆய்வு சோதித்தது.
VUB-இன் செயற்கை நுண்ணறிவுப் பேராசிரியரும் இணை ஆசிரியருமான Paul Van Eecke, சிவப்பு நிறக் காரை அடையாளம் காணும் மனிதர்களை எடுத்துக்காட்டாகக் கொண்டு இதற்கான காரணத்தை விளக்கினார். அவர்களின் கண்கள் நிறத்தைச் சற்றே மாறுபட்ட மதிப்புகளாகப் பதிவு செய்தாலும், ஒரே விளக்கத்தை அவர்களால் புரிந்துகொள்ள முடியும். அந்தத் தனிப்பட்ட பதிவுகளுக்கு அப்பாற்பட்டு பொதுவான சொல் அமைகிறது.
முகவர்களின் கவனிப்புகளை மாற்றியமைத்து, பரிசோதனைகளில் அந்தக் கருத்தை ஆராய்ச்சியாளர்கள் பயன்படுத்தினர். அளவுத்திருத்த வேறுபாடுகளை ஒத்த எண் இடமாற்றங்கள், கவனிக்கப்பட்ட மதிப்புகளில் இரைச்சல், வெவ்வேறு எண்ணிக்கையிலான பண்புகள் கிடைக்கக்கூடிய முகவர்களைக் கொண்ட குழுக்கள் ஆகியவை இதில் இடம்பெற்றன.
CLEVR பரிசோதனைகளில் அதிக இரைச்சல் இருந்தபோது, தொடர்பாடல் வெற்றி 87.67% ஆக இருந்தது. கிடைக்கக்கூடிய உணரிகளில் பெரிய வேறுபாடுகள் இருந்த சூழலில், வெற்றி 83.47% ஆக இருந்தது. வழக்கமான CLEVR பரிசோதனையைவிடத் துல்லியம் குறைந்திருந்தாலும், இந்த நிலைமைகளில் ஒருங்கிணைந்து செயல்படும் கணிசமான திறனை இந்த முறை தக்கவைத்தது.
வெவ்வேறு புலனுணர்வு அமைப்புகளைக் கொண்ட குழுக்களை, வேற்றுருவக் குழுக்கள் என்று கட்டுரை விவரிக்கிறது. எளிமையாகச் சொன்னால், அவற்றின் உறுப்பினர்களுக்குக் கிடைக்கும் தகவலின் வகைகளோ அளவுகளோ வேறுபடுகின்றன. ஒவ்வொரு உறுப்பினரும் அணுகக்கூடிய கவனிப்புகளைப் பயன்படுத்தி, அந்த வேறுபாடுகள் இருந்தபோதும் பொருந்தக்கூடிய குறிப்புகளை உருவாக்குவதே அவற்றின் பணி.
உள்ளீடுகள் மறையும்போது மாறும் சொற்களஞ்சியம்
கற்றலின்போது தகவல் திடீரென இழக்கப்படுவதையும் ஆராய்ச்சியாளர்கள் சோதித்தனர். ஒரு பரிசோதனையில், உணரிகளின் அளவீடுகளைக் குறிக்கும் உள்ளீடுகளில் பாதி, செயல்முறையின் நடுப்பகுதியில் நீக்கப்பட்டன. அந்த மாற்றத்துக்குப் பிறகு தொடர்பாடல் வெற்றி 93.82% ஆக இருந்தது.
நிலைமைகள் மாறும்போது தங்கள் கருத்துகளைத் திருத்திக்கொள்ள, தொடர்ச்சியான தொடர்பாடல் முகவர்களுக்கு வாய்ப்பளிக்கிறது. பல பண்புகளுடன் தொடர்புடைய ஒரு சொல், அவற்றில் சில மறைந்து, மீதமுள்ள கவனிப்புகள் கூடுதல் முக்கியத்துவம் பெறும்போது வேறொரு விதத்தில் பயனுள்ளதாகலாம்.
சுற்றுச்சூழல் மாற்றங்களுக்கு ஏற்றவாறு முகவர்கள் செயல்படுவதையும் கட்டுரை தெரிவிக்கிறது. இதனால் தொடர்ச்சியான கற்றல் இந்த அணுகுமுறையின் மையப் பகுதியாகிறது: பயன்பாட்டின் மூலம் குழு ஒரு பொதுவான வழக்கத்தை உருவாக்கி, அதன் கவனிப்புகள் மாறும்போது அதைத் தொடர்ந்து சரிசெய்கிறது.
எதிர்கால இயந்திர அமைப்பில், சாதனங்கள் பழுதடையும்போதோ செயல்பாட்டு நிலைமைகள் மாறும்போதோ இந்தத் திறன் முக்கியமாக இருக்கலாம். உருவகப்படுத்தப்பட்ட பணிகளுக்குள் முகவர்கள் தங்கள் சொற்களஞ்சியத்தை மாற்றியமைக்க முடியும் என்பதே தற்போதைய பரிசோதனையின் நேரடி கண்டுபிடிப்பு.
பெரிய குழுக்களுக்கு அதிகப் பரிமாற்றங்கள் தேவை
2, 10, 25, 50 மற்றும் 100 முகவர்கள் கொண்ட குழுக்களை இந்த ஆய்வு ஆராய்ந்தது. பயனுள்ள ஒரு சொல் எவ்வளவு பரவலாகச் சென்றடைய வேண்டும் என்பதில், குழுவின் அளவு தாக்கம் செலுத்துகிறது; ஏனெனில் பரிமாற்றங்கள் தனிப்பட்ட முகவர் ஜோடிகளுக்கு இடையேதான் நிகழ்கின்றன.
100 முகவர்கள் கொண்ட CLEVR பரிசோதனைகளில், ஒரு மில்லியன் பரிமாற்றங்களுக்குப் பிறகு தொடர்பாடல் வெற்றி 92.69% ஆக இருந்தது. பயிற்சியை 10 மில்லியன் பரிமாற்றங்களாக நீட்டித்தபோது வெற்றி 99.16% ஆக உயர்ந்தது; இது 6.47 சதவீதப் புள்ளிகள் அதிகரிப்பாகும்.
கற்றலுக்கான பரிமாற்றங்களின் எண்ணிக்கை, இந்தச் சவாலின் அளவை விளக்குகிறது. பங்கேற்பு சமமாகப் பகிரப்பட்டால், ஒவ்வொரு பரிமாற்றத்திலும் இரு முகவர்கள் பங்கேற்கும் ஒரு மில்லியன் பரிமாற்றங்கள், 10 முகவர்கள் கொண்ட குழுவில் ஒவ்வொரு முகவருக்கும் சராசரியாக 200,000 பங்கேற்புகளை வழங்கும். 100 பேர் கொண்ட குழுவில் அதே எண்ணிக்கையிலான பரிமாற்றங்கள் ஒவ்வொரு முகவருக்கும் சராசரியாக 20,000 பங்கேற்புகளையே வழங்கும்.
10 மில்லியன் பரிமாற்றங்கள், 100 பேர் கொண்ட குழுவில் ஒவ்வொரு உறுப்பினருக்கும் சராசரியாக 200,000 பங்கேற்புகளை மீண்டும் வழங்குகின்றன. தனித்தனி சந்திப்புகள் சீரற்ற முறையில் தேர்ந்தெடுக்கப்பட்டாலும், பொதுவான வழக்கங்கள் குழுவெங்கும் பரவுவதற்கு பெரிய குழுவுக்கு ஏன் மிக அதிகமான மொத்தக் கற்றல் ஒதுக்கீடு தேவைப்படலாம் என்பதை இந்த ஒப்பீடு காட்டுகிறது.
ஒரு சொல் எதைக் குறிக்கிறது என்பதை மனிதர்கள் ஆய்வு செய்யலாம்
தங்கள் வடிவமைப்பின் ஒரு நன்மையாக விளக்கத்தன்மையை ஆராய்ச்சியாளர்கள் குறிப்பிடுகின்றனர். ஒரு சொல், அதன் மதிப்புகளையும் பண்பு எடைகளையும் ஆய்வு செய்யக்கூடிய முன்மாதிரியைக் குறிக்கிறது. ஒரு கருத்து உருவாக எந்தக் கவனிப்புகள் உதவின, பயன்பாட்டின்போது அதன் பிரதிநிதித்துவம் எப்படி மாறுகிறது என்பதையும் ஆராய்ச்சியாளர்கள் கண்காணிக்கலாம்.
பெயரிடப்பட்ட வேதியியல் அளவீடுகளைக் கொண்ட தரவுத்தொகுப்பில், ஆய்வு ஒரு சொல்லை அந்த அளவீடுகளின் குறிப்பிட்ட வரம்புகளுடன் இணைக்கலாம். படத் தரவுகளில், கருத்து பார்வைக் குறியாக்கி உருவாக்கும் பண்புகளுடன் பிணைக்கப்பட்டிருக்கும். எனவே, அதன் பொருளை விளக்குவதற்கு அந்த எண் வடிவிலான படப் பிரதிநிதித்துவங்களைப் புரிந்துகொள்வதும் அவசியம்.
VUB-இன் செயற்கை நுண்ணறிவு ஆய்வகத்தைச் சேர்ந்த முனைவர் பட்ட ஆய்வாளரும் இணை ஆசிரியருமான Jérôme Botoko Ekila, முகவர்கள் தங்கள் சொந்தப் புலனுணர்வுகளைச் சுற்றிக் கருத்துகளை உருவாக்க அனுமதிப்பதன் நோக்கத்தை இவ்வாறு விளக்கினார்:
தரவு மனிதர்களுக்குப் புரியாததாக இருந்தாலும், உணரிகள் மூலம் அவர்கள் உணர்வதற்கு மிகத் துல்லியமாகப் பொருந்தும் பயனுள்ள கருத்துகளை அவை உருவாக்குகின்றன.
அந்தத் தொடர்புகள் உருவாகும்போது அவற்றை ஆய்வு செய்வதே மனிதக் கண்காணிப்பில் அடங்கும். உள்ளீடுகளோ சூழலோ மாறிய பிறகும், ஒரே சொல்லைப் பயன்படுத்தும் இரண்டு முகவர்கள் நோக்கப்பட்ட பொருளைத் தொடர்ந்து தேர்ந்தெடுக்கின்றனவா என்பதைச் சரிபார்ப்பது பயனுள்ள வழியாகும். கற்றலின் மையத்தில் இந்த உறவைப் பின்னூட்டச் செயல்முறை வைக்கிறது.
வெளியீடு, ஒத்துழைப்பு மற்றும் சாத்தியமான பயன்பாடுகள்
இந்த ஆய்வில் VUB-ஐச் சேர்ந்த Jérôme Botoko Ekila, Lara Verheyen, Jens Nevens மற்றும் Paul Van Eecke, நமூர் பல்கலைக்கழகத்தைச் சேர்ந்த Katrien Beuls ஆகியோர் இணைந்து பணியாற்றினர். FWO திட்டம் மற்றும் FNRS திட்டம் வழியாக ஃபிளாண்டர்ஸ் ஆராய்ச்சி அறக்கட்டளை (FWO), பெல்ஜிய தேசிய ஆராய்ச்சி நிதியம் (FNRS) ஆகியவை நிதியுதவி வழங்கின.
VUB-இன் வெளியீட்டுப் பதிவு, இதழின் பெயர் Transactions of the Association for Computational Linguistics என்றும், தொகுதி 14, பக்கங்கள் 2234–2257, DOI 10.1162/TACL.a.799 என்றும் குறிப்பிடுகிறது. அதில் வெளியீட்டு மாதம் 2026 ஆகஸ்ட் எனப் பட்டியலிடப்பட்டுள்ளது.
வெளியீடும் அறிவிப்பும் பின்வரும் வரிசையில் இடம்பெற்றன:
- 2026 ஏப்ரல்: கட்டுரை சமர்ப்பிக்கப்பட்டது.
- 2026 மே: கட்டுரை திருத்தப்பட்டது.
- 2026 ஆகஸ்ட்: பல்கலைக்கழக வெளியீட்டுப் பதிவில் இதழ் வெளியீடு குறிப்பிடப்பட்டுள்ளது.
- 2026 அக்டோபர் 14: பல்கலைக்கழக அறிவிப்பு ஆய்வு முடிவுகளை வெளியிட்டது.
இயந்திரப் புலனுணர்வுகளுக்கு ஏற்ற தொடர்பாடல் முறைகளைப் பயன்படுத்தக்கூடியவையாக தன்னாட்சி வாகனங்கள், ரோபோக்கள் மற்றும் தொழில்துறை உணரிகளை ஆராய்ச்சியாளர்கள் குறிப்பிடுகின்றனர். லிடார் ஒளியைப் பயன்படுத்தி தூரத்தை அளவிடுகிறது; சோனார் ஒலியைப் பயன்படுத்துகிறது; அகச்சிவப்பு உணரிகள் வெப்பநிலையுடன் தொடர்புடைய கதிர்வீச்சைக் கண்டறிகின்றன; வேதியியல் கருவிகள் பொருட்களை அளவிடுகின்றன. இத்தகைய உள்ளீடுகளில் உள்ள பயனுள்ள வடிவங்களைக் குறிப்பிட இயந்திரங்களுக்கு ஒரு பொதுவான சொற்களஞ்சியம் உதவக்கூடும்.
இந்தப் பொதுவான வழக்கங்கள் நடைமுறைச் சாதனங்கள், மாறும் சூழல்கள் மற்றும் செயல்பாட்டுத் தேவைகளில் எவ்வாறு செயல்படுகின்றன என்பதைச் சோதிப்பதே அடுத்த நடைமுறைப் படியாக இருக்கும். செயல்படுத்துவதற்கான கால அட்டவணை எதுவும் தெரிவிக்கப்படவில்லை. தற்போதைக்கு, பல்வேறு தரவுகளில் பகிரப்பட்ட குறிப்புகளை உருவாக்குவதற்கான சோதிக்கப்பட்ட முறையையும், இரைச்சல், புலனுணர்வு வேறுபாடுகள் மற்றும் உள்ளீடுகள் இழப்பு ஆகிய நிலைமைகளில் அதன் அளவிடக்கூடிய செயல்திறனையுமே இந்த முடிவு காட்டுகிறது.
முக்கிய அம்சங்கள்
- VUB மற்றும் நமூர் பல்கலைக்கழக ஆராய்ச்சியாளர்கள் 37 பொதுத் தரவுத்தொகுப்புகளில் சொற்களஞ்சிய உருவாக்கத்தைச் சோதித்தனர்.
- 10 முகவர்கள் கொண்ட குழுக்கள் ஒரு மில்லியன் பரிமாற்றங்கள் வழியாகப் பயிற்றுவிக்கப்பட்டு, பின்னர் 100,000 சோதனைப் பரிமாற்றங்களை எதிர்கொண்டன.
- முக்கியமாகக் குறிப்பிடப்பட்ட ஏழு தரவுத்தொகுப்புகளில் வெற்றி 95.77% முதல் 99.76% வரை இருந்தது.
- கற்றல் செயல்முறைகளை ஆராய்ச்சியாளர்கள் வழங்கினர்; பின்னூட்டத்தின் மூலம் குறிப்பிட்ட சொற்களையும் அவற்றுடன் தொடர்புடைய கருத்துகளையும் முகவர்கள் உருவாக்கின.
- இரைச்சல் நிறைந்த கவனிப்புகள், வெவ்வேறு புலனுணர்வு அமைப்புகள் மற்றும் விடுபட்ட உள்ளீடுகளுக்கு ஏற்றவாறு மாறும் திறனைப் பரிசோதனைகள் சோதித்தன.
- 100 முகவர்கள் கொண்ட குழு, 10 மில்லியன் பரிமாற்றங்களுக்குப் பிறகு CLEVR-இல் 99.16% வெற்றியை எட்டியது.
- இந்த ஆய்வு கணினி உருவகப்படுத்தல்களைப் பயன்படுத்தியது. ரோபோக்கள், வாகனங்கள் மற்றும் தொழில்துறை உணரிகளில் பயன்பாடுகளை ஆராய்ச்சியாளர்கள் முன்மொழிகின்றனர்.