செயலாக்க வேகத்துடன் நினைவகத் திறனுக்கும் முக்கியத்துவம் அளிக்கும் சாம்சங்
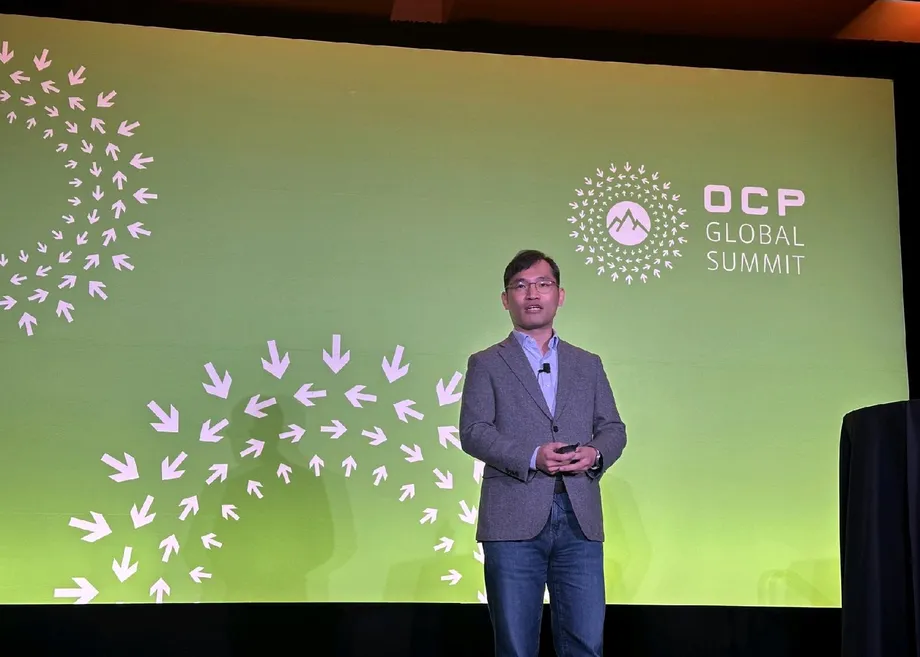
அதிக அலைவரிசை நினைவகத்தைத் தாண்டி, தனது AI உள்கட்டமைப்பு உத்தியை சாம்சங் எலக்ட்ரானிக்ஸ் விரிவுபடுத்தி வருகிறது. HBM5 மற்றும் தனிப்பயனாக்கப்பட்ட நினைவகத்துடன், பகிரப்பட்ட சர்வர் நினைவகம் தொடர்பான AMD உடனான ஒத்துழைப்பையும், தரவுச் செயலாக்கத்தின் ஒரு பகுதியை SSD-களுக்கு மாற்றும் சேமிப்பகத் தொழில்நுட்பங்களையும் அது இணைக்கிறது. கலிஃபோர்னியாவின் சான் ஜோஸில் உள்ள மெக்கனெரி மாநாட்டு மையத்தில் அக்டோபர் 12 முதல் 15 வரை நடைபெறத் திட்டமிடப்பட்ட OCP குளோபல் உச்சிமாநாடு 2026-இல் இந்த அணுகுமுறையை நிறுவனம் முன்வைத்தது.
உள்ளடக்கம்
- செயலாக்க வேகத்துடன் நினைவகத் திறனுக்கும் முக்கியத்துவம் அளிக்கும் சாம்சங்
- விரிவான வேக உத்தியின் மையத்தில் HBM5
- நெகிழ்வான நினைவகத் திறனை இலக்காகக் கொண்ட AMD ஒத்துழைப்பு
- நினைவக விரிவாக்கத்தையும் சேமிப்பகத்தையும் இணைக்கும் KV கேச்
- திறன், குளிர்விப்பு, தரவு அமைவிடம் ஆகியவற்றைக் கவனிக்கும் SSD-கள்
- சேமிக்கப்பட்ட தரவுக்கு அருகே கணக்கீட்டைக் கொண்டு செல்வது
- வாடிக்கையாளர் சோதனைகளும் ஃபவுண்ட்ரி கண்காட்சிகளும் திட்டத்தை விரிவுபடுத்துகின்றன
- பல மாதங்களாக வளர்ந்த கூட்டாண்மை
- சந்தை அளவு வணிகத் தயார்நிலையை உறுதிப்படுத்தாது
- முக்கிய அம்சங்கள்
நினைவகப் படிநிலையில் உள்ள பிற தொழில்நுட்பங்கள் தொடர்பாகவே மிகத் தெளிவான செயல்திறன் கூற்றுகள் முன்வைக்கப்பட்டுள்ளன. மீள்திறன் கொண்ட CXL நினைவக ஒதுக்கீட்டின் மூலம் AI மாதிரி தனது முதல் டோக்கனை உருவாக்கும் வரையிலான நேரம் 38% வரை குறைவதாகவும், LPDDR5X-இல் நினைவகத்திலேயே செயலாக்கம் செய்வதன் மூலம் ஊகச் செயல்திறன் மூன்று மடங்கு வரை அதிகரிப்பதாகவும், SSD-களின் தொடர் வாசிப்பு வேகம் 28.4 GB/s எட்டுவதாகவும் சாம்சங் தெரிவிக்கிறது. இவை குறிப்பிட்ட மதிப்பீடுகள் அல்லது செயல்விளக்கங்களின் முடிவுகள்; ஒவ்வொரு AI நிறுவலுக்கும் இவை உறுதியான பலன்கள் என்பதல்ல.
சாம்சங்கின் அதிகாரப்பூர்வ உச்சிமாநாட்டுப் பக்கம் வேகம், நினைவக விரிவாக்கம், தரவுத் தக்கவைப்பு ஆகியவற்றை மையமாகக் கொண்டு அதன் உத்தியை அமைத்துள்ளது. HBM4E, LPDDR5X-PIM, CMM-D MD310 நினைவகத் தொகுதி, SOCAMM2 சர்வர் நினைவகம், PM1763 மற்றும் BM1773 SSD-கள் ஆகியவை அதில் இடம்பெறும் தயாரிப்புகள்.
நினைவக வணிகப் பயன்பாட்டுப் பொறியியல் குழுவின் தலைவரும் நிறுவனத்தின் துணைத் தலைவருமான ஹோஜுன் ஷிம், இந்த மூன்று முன்னுரிமைகள் குறித்து அக்டோபர் 12 அன்று நடைபெறும் நிர்வாக அமர்வில் பேசத் திட்டமிடப்பட்டிருந்தார் என சாம்சங் தெரிவித்துள்ளது. ஒவ்வொரு பாகத்தையும் தனித்தனியாக மேம்படுத்துவதற்குப் பதிலாக, செயலிகள், நினைவகம், சேமிப்பகம் ஆகியவற்றை ஒன்றாக மேம்படுத்தும் பரந்த முயற்சியின் தொடக்கமாக இந்த விளக்கக்காட்சி அமைந்ததாகச் செய்திகள் குறிப்பிடுகின்றன.
பயிற்சி பெற்ற ஒரு மாதிரி பதில்களை உருவாக்கும் ஊகச் செயலாக்கத்தின்போது இந்த வேறுபாடு முக்கியமானது. வேகமான முடுக்கி இருந்தாலும், தரவுக்காகக் காத்திருக்க வேண்டியிருக்கலாம்; உரையாடல்கள் நீளும்போது நினைவகம் போதாமல் போகலாம்; அல்லது சேமிப்பகத்திலிருந்து தகவலை மீட்டெடுப்பதில் தாமதம் ஏற்படலாம். இந்த ஒவ்வொரு தடைக்கும் தனித்தனி தொழில்நுட்பங்களை சாம்சங் முன்மொழிகிறது.
விரிவான வேக உத்தியின் மையத்தில் HBM5
கண்காட்சியில் சாம்சங்கின் வேக முயற்சிகளில் எட்டாம் தலைமுறை அதிக அலைவரிசை நினைவகமாகக் குறிப்பிடப்படும் HBM5, தனிப்பயனாக்கப்பட்ட HBM, zHBM ஆகியவை இடம்பெற்றதாகச் செய்திகள் தெரிவிக்கின்றன. பல இணைப்புகள் வழியாக முடுக்கிக்கு அதிக அளவிலான தரவை அதிக அலைவரிசை நினைவகம் வழங்குகிறது. தனிப்பயனாக்கப்பட்ட பதிப்புகள் ஒவ்வொரு வாடிக்கையாளரின் அமைப்புத் தேவைகளுக்கும் ஏற்றவாறு உருவாக்கப்படுகின்றன.
அதிகாரப்பூர்வ தயாரிப்புப் பட்டியலில் HBM5-க்குப் பதிலாக HBM4E குறிப்பிடப்பட்டுள்ளது. கண்காட்சியில் HBM4E மற்றும் HBM5 கருத்துரு மாதிரிகள் இடம்பெற்றதாக மற்ற செய்திக் குறிப்புகள் தெரிவிக்கின்றன. இந்த வேறுபாடு முக்கியமானது: கண்காட்சி அல்லது கருத்துரு விளக்கக்காட்சி இடம்பெற்றிருப்பது மட்டும் ஒரு தயாரிப்பு விற்பனைக்கு வந்துவிட்டதை உறுதிப்படுத்தாது. மேலும், HBM5 வணிக ரீதியில் வெளியிடப்படும் தேதி அல்லது விரிவான செயல்திறன் விவரங்களை சாம்சங்கின் உச்சிமாநாட்டுப் பக்கம் வழங்கவில்லை.
செயலாக்க வேகத்துக்கான மிக வலுவான எண் சார்ந்த ஆதாரம் LPDDR5X-PIM ஆகும். நினைவகத்திலேயே செயலாக்கம் செய்வது, சில கணக்கீடுகளை நினைவகச் சாதனத்துக்குள் மேற்கொள்கிறது; இதனால் நினைவகத்துக்கும் தனி செயலிக்கும் இடையே மீண்டும் மீண்டும் தரவை மாற்ற வேண்டிய தேவை குறைகிறது. ஒவ்வொரு நினைவக வங்கியிலும் செயலாக்க அலகுகளைத் தனது வடிவமைப்பு ஒருங்கிணைக்கிறது என சாம்சங் கூறுகிறது.
சாம்சங் எட்ஜ் AI முடுக்கியில் Llama 3.1 8B மாதிரியைப் பயன்படுத்திய மதிப்பீட்டில், வழக்கமான LPDDR5X-ஐ விட பயனுள்ள அலைவரிசை எட்டு மடங்கு வரை அதிகரித்ததாகவும், வினாடிக்கு உருவாக்கப்படும் டோக்கன்கள் மூன்று மடங்கு வரை அதிகரித்ததாகவும், செயலாக்க நேரம் 2.2 மடங்கு வரை குறைந்ததாகவும் சாம்சங் தெரிவிக்கிறது. இந்த எண்கள் அந்த முடுக்கி மற்றும் மாதிரிக்கானவை; HBM5-க்கோ AMD நினைவகச் செயல்விளக்கத்துக்கோ உரியவை அல்ல.
இடம்பெற்ற மற்றொரு தயாரிப்பான SOCAMM2, LPDDR அடிப்படையிலான சர்வர் நினைவகத் தொகுதியாகும். இந்தக் கண்காட்சிகள், முடுக்கி நினைவகம் மட்டுமின்றி குறைந்த மின்சக்தி நுகரும் நினைவகத் தொழில்நுட்பங்களையும் சாம்சங்கின் வேக உத்தி உள்ளடக்கியிருப்பதைக் காட்டுகின்றன. இருப்பினும், ஒவ்வொரு தயாரிப்புக்கும் ஒப்பிடத்தக்க செயல்திறன் மதிப்பீட்டு முடிவுகளை உச்சிமாநாட்டுப் பக்கம் வழங்கவில்லை.
நெகிழ்வான நினைவகத் திறனை இலக்காகக் கொண்ட AMD ஒத்துழைப்பு
சாம்சங்கும் AMD-யும் சாம்சங்கின் CMM-D தொழில்நுட்பத்தைப் பயன்படுத்தி CXL நினைவக விரிவாக்கத்தைச் செயல்விளக்கின. கம்ப்யூட் எக்ஸ்பிரஸ் லிங்க் என்பதன் சுருக்கமான CXL, செயலிகளையும் பிற சாதனங்களையும் கூடுதல் நினைவகத்துடன் இணைக்கிறது. இதன் மூலம், நேரடியாக நிறுவப்பட்ட நினைவகத்தைத் தாண்டி அமைப்புகள் தங்கள் திறனை விரிவாக்கலாம்.
CMM-D என்பது CXL அடிப்படையிலான DRAM நினைவகத் தொகுதி. திரட்டப்பட்ட அமைப்பில், பல சர்வர்களுக்குத் தனித்தனியாக ஒதுக்கப்பட்டு நிரந்தரமாகப் பயன்படுத்தப்படாமல் இருக்கும் திறனுக்குப் பதிலாக, இணைக்கப்பட்ட நினைவக வளங்களிலிருந்து பல அமைப்புகள் திறனைப் பகிர்ந்து கொள்ளலாம். CPU கருக்கள் தரவுக்காகக் காத்திருக்கும் நேரத்தைக் குறைத்தபடி, நினைவகத் திறனையும் அலைவரிசையையும் விரிவாக்குவதற்கான வழியாக CXL-ஐ AMD உடனான ஒத்துழைப்பு உறுதிப்படுத்தியதாக சாம்சங் கூறுகிறது.
AI முகவர்கள் பல மாதிரிகள் அல்லது பணிகளை இயக்கும்போது இந்தச் சிக்கல் மேலும் தீவிரமடைகிறது. முகவர் பணிச்சுமைகள் CPU பயன்பாட்டைத் திடீரென அதிகரிக்கலாம்; அதேவேளை, செயலி கருக்களின் எண்ணிக்கைக்கேற்ப நினைவகத் திறன் அதிகரிக்காமல் போகலாம் என சாம்சங்கின் அதிகாரப்பூர்வ விளக்கம் கூறுகிறது.
GPU சர்வரில் பல பெரிய மொழி மாதிரிப் பிரதிகளுக்கு இடையே மீள்திறன் கொண்ட ஒதுக்கீட்டைச் செய்த தனியான CMM-D திரட்டல் செயல்விளக்கம் ஒன்றிலும் பயன்படுத்தப்பட்டது. நிலையான ஒதுக்கீட்டுடன் ஒப்பிடும்போது, முதல் டோக்கனுக்கான நேரம் (TTFT) 38% வரை குறைந்ததாகவும், பயனுள்ள செயலாக்க அளவு (goodput) 3.3 மடங்கு வரை அதிகரித்ததாகவும் சாம்சங் தெரிவிக்கிறது. பதில் தொடங்குவதற்கு முன் காத்திருக்கும் நேரத்தை TTFT அளவிடுகிறது; மதிப்பீட்டின் அளவுகோல்களின்படி வழங்கப்படும் பயனுள்ள பணியை goodput அளவிடுகிறது.
இந்த முடிவுகளை AMD செயல்விளக்கத்தின் எண் சார்ந்த முடிவுகளாகக் கருதக் கூடாது. AMD உடனான சரிபார்ப்பையும் மீள்திறன் ஒதுக்கீட்டு மதிப்பீட்டையும் அதிகாரப்பூர்வப் பக்கம் தனித்தனியாக விவரிக்கிறது. வெவ்வேறு மாதிரிகள், சர்வர் அமைப்புகள் அல்லது சேவை இலக்குகளைப் பயன்படுத்தும்போது இந்தப் பலன்கள் எவ்வாறு மாறும் என்பதை உறுதிப்படுத்தப் போதுமான விவரங்களும் அதில் இல்லை.
நினைவக விரிவாக்கத்தையும் சேமிப்பகத்தையும் இணைக்கும் KV கேச்
சாம்சங்கின் நினைவகம் மற்றும் சேமிப்பகத் திட்டங்களை இணைக்கும் முக்கிய அம்சம், கீ-வேல்யூ கேச் (KV கேச்) எனப்படும் நினைவகத் தேக்கமாகும். மொழி மாதிரி உரையைச் செயலாக்கும்போது உருவாகும் இடைநிலைத் தகவல்களை இது தக்கவைக்கிறது. இதனால் ஒவ்வொரு புதிய டோக்கனுக்கும் மீண்டும் கணக்கிடாமல், ஏற்கெனவே செய்த பணியை மாதிரி பயன்படுத்திக்கொள்ள முடியும்.
நீண்ட உரையாடல்கள், பெரிய சூழல் அளவுகள், ஒரே நேரத்தில் பல பயனர்கள் ஆகியவை இந்தக் கேச் நினைவகத்தில் கணிசமான இடத்தைப் பிடிக்கச் செய்யலாம். CXL நினைவகம் கிடைக்கும் திறனை விரிவாக்கவும், மிக வேகமான நினைவகப் படிநிலையில் தொடர்ந்து இருக்கத் தேவையில்லாத கேச் தரவை SSD-களில் சேமிக்கவும் வழிவகுக்கும் படிநிலை அமைப்பை சாம்சங் முன்மொழிகிறது.
சாம்சங் செமிகண்டக்டரின் அமெரிக்க வளாகத்தில், நிறுவனத்துக்குள் பயன்படுத்தப்படும் AI குறியீட்டு முகவர் உள்ளிட்ட பயன்பாடுகளுக்காக அமைக்கப்பட்ட உற்பத்திப் பயன்பாட்டை அதிகாரப்பூர்வ உச்சிமாநாட்டுப் பக்கம் விவரிக்கிறது. தனது AI Memory Node தீர்வின் மூலம் L3.5 கலவையமைக்கக்கூடிய நினைவகப் படிநிலையைச் சேர்த்தபோது, KV கேச் பயன்பாடு ஐந்து முதல் ஏழு மடங்கு அதிகரித்ததாக சாம்சங் கூறுகிறது.
அந்தக் கூடுதல் படிநிலைக்குப் பயன்படுத்தப்படும் பெயர்தான் L3.5; எல்லா சர்வர்களிலும் ஒரே மாதிரியான கேச் கட்டமைப்பு உள்ளது என்பதற்கான கூற்று அல்ல. இந்தப் பயன்பாட்டில் சாம்சங்கின் Memory Solutions Lab, அதன் DSA AI Platform Integrations குழு, SGLang ஆகியவை ஈடுபட்டன. பயன்பாட்டு அதிகரிப்பு குறித்த முடிவு, மீள்திறன் ஒதுக்கீட்டு மதிப்பீட்டிலிருந்தும் LPDDR5X-PIM செயல்திறன் புள்ளிவிவரங்களிலிருந்தும் வேறுபட்டது.
KV கேச் இடமாற்றத்திற்காக CXL திரட்டலையும் SSD சேமிப்பகத்தையும் இணைப்பது குறித்து அக்டோபர் 13 அமர்வும் உச்சிமாநாட்டு அட்டவணையில் இடம்பெற்றது. அந்த அமர்வை அமைப்புக் கட்டமைப்பாளர் ஜினின் சோவும் முதன்மைப் பொறியாளர் யங்ஹா சோயும் வழங்கத் திட்டமிடப்பட்டிருந்தனர். இந்த இணைப்பு, வெறும் திறன் மேம்பாட்டைத் தாண்டியதாக உத்தியை மாற்றுகிறது: அளவுக்கு அதிகமான தாமதங்களை ஏற்படுத்தாமல் நினைவகம் மற்றும் சேமிப்பகத்தில் தரவை வைப்பதற்கும் மீட்டெடுப்பதற்கும் மென்பொருள் தேவைப்படுகிறது.
திறன், குளிர்விப்பு, தரவு அமைவிடம் ஆகியவற்றைக் கவனிக்கும் SSD-கள்
சாம்சங்கின் தரவுத் தக்கவைப்பு உத்தி நிறுவனப் பயன்பாட்டு SSD-களையும் அதிக திறன் கொண்ட NAND ஃபிளாஷையும் மையமாகக் கொண்டுள்ளது. தரவுத் தக்கவைப்பு என்பது கணக்கீட்டின் தற்காலிகச் செயல்நிலைக்கு அப்பாலும் தரவைப் பாதுகாப்பதாகும். இதன் மூலம் AI அமைப்புகள் தேவைப்படும்போது தரவுத் தொகுப்புகள், மாதிரிக் கோப்புகள், சேமிக்கப்பட்ட கேச் தகவல்கள் ஆகியவற்றை மீட்டெடுக்கலாம்.
PM1763, PCIe Gen6 நிறுவனப் பயன்பாட்டு SSD ஆக முன்வைக்கப்பட்டுள்ளது. இதன் தொடர் வாசிப்பு வேகம் 28.4 GB/s வரை எட்டும்; முந்தைய தயாரிப்பை விட மின்சக்தித் திறன் 1.8 மடங்கு வரை அதிகம். சாம்சங்கின் திரவக் குளிர்விப்பு செயல்விளக்கத்தில், E1.S பதிப்பு வெப்பத்தை வெளியேற்றும் குளிர்தகட்டுடன் நேரடியாகத் தொடர்பில் வைக்கப்பட்டுள்ளது. செயல்திறன் ஒப்பீட்டுக்கான முழுமையான சோதனைச் சூழல்களை அதிகாரப்பூர்வப் பக்கம் வழங்கவில்லை.
BM1773, 256TB QLC சேமிப்பகத்தைக் கொண்ட E3.S SSD ஆகப் பட்டியலிடப்பட்டுள்ளது. குவாட் லெவல் செல் என்பதன் சுருக்கமான QLC, ஒவ்வொரு ஃபிளாஷ் செல்லிலும் நான்கு பிட்களைச் சேமித்து அதிக திறனை வழங்குகிறது. அதிக திறன் கொண்ட QLC ஃபிளாஷ் மற்றும் நெகிழ்வான தரவு அமைவிடத் தொழில்நுட்பத்தை சாம்சங் தொடர்ந்து மேம்படுத்தி வருவதாகவும் செய்திகள் தெரிவிக்கின்றன.
LMCache-இல் ஒருங்கிணைக்கப்பட்ட KV கேச் மேம்படுத்தல்களை சாம்சங் செயல்விளக்கிக் காட்டியது. நெகிழ்வான தரவு அமைவிடம் (FDP), தரவை எழுதும் இடத்தை ஒழுங்குபடுத்தி, எழுதுதல் பெருக்கத்தைக் குறைக்க உதவுகிறது. ஹோஸ்ட் சமர்ப்பித்த தரவைத் தாண்டி SSD உள்முறையில் கூடுதலாக எழுதுவதையே எழுதுதல் பெருக்கம் என்கிறார்கள்.
ஹோஸ்ட் CPU-வின் பணிச்சுமையைக் குறைக்க அதிகபட்ச NVMe தரவு பரிமாற்ற அளவைப் பயன்படுத்துவதும் இந்தச் செயல்விளக்கத்தில் இடம்பெற்றது. ஒரே முனையிலுள்ள கேச் சேமிப்பகத்திற்கும், சர்வர் குழுவெங்கும் பகிரப்படும் கேச் வளங்களுக்கும் இந்த உத்திகள் பொருந்தும் என சாம்சங் கூறுகிறது. இந்தச் சிறப்பு மேம்பாடுகளுக்கான எண் சார்ந்த பலனை நிகழ்வு தொடர்பான பக்கத்தில் அது வழங்கவில்லை.
சேமிக்கப்பட்ட தரவுக்கு அருகே கணக்கீட்டைக் கொண்டு செல்வது
தரவு நகர்வைக் குறைப்பதற்கான மற்றொரு வழியை சாம்சங்கின் வெக்டர் தரவுத்தளச் செயல்விளக்கம் காட்டுகிறது. வெக்டர் தரவுத்தளங்கள் தகவலின் எண் வடிவப் பிரதிகளைச் சேமித்து, ஒத்த உருப்படிகளைக் கண்டறிய அவற்றை ஒப்பிடுகின்றன. ஒரு கோரிக்கைக்குப் பொருத்தமான ஆவணங்களை AI பயன்பாடு மீட்டெடுக்கும்போது இது பொதுவாக நடைபெறும் படியாகும்.
NCVS கருத்துச் சான்று, வெக்டர் தூரக் கணக்கீடுகளை SSD-களுக்குள் மாற்றுகிறது. ஒப்பிடுவதற்காக 4KB வெக்டரை ஹோஸ்டுக்கு அனுப்புவதற்குப் பதிலாக, சாதனம் நான்கு பைட் தூர முடிவைத் திருப்பி அனுப்புகிறது. வழக்கமான ஹோஸ்ட் செயலாக்க முறையுடன் ஒப்பிடும்போது, ஹோஸ்ட் வழியாகச் செல்லும் தரவு 22 மடங்கு வரை குறைவதாகவும், கூடுதல் SSD-களைச் சேர்க்கும்போது தேடல் செயல்திறன் அதிகரிப்பதாகவும் சாம்சங் தெரிவிக்கிறது.
நான்கு பைட் மற்றும் 4KB என்ற எண்கள் தனிப்பட்ட முடிவுகள் மற்றும் வெக்டர்களின் அளவைக் குறிக்கின்றன; முழுப் பயன்பாட்டின் தரவுப் போக்குவரத்தும் அதே விகிதத்தில் குறைகிறது என்பதல்ல. 22 மடங்கு வரையிலான குறைவு என்பது பரந்த அளவிலான ஒப்பீட்டில் அளவிடப்பட்ட முடிவாகும். NCVS-ஐ பொதுவாகக் கிடைக்கும் தயாரிப்பாக அல்ல, கருத்துச் சான்றாகவே சாம்சங் குறிப்பிடுகிறது.
GPU தொடங்கும், சாதனங்களுக்கு இடையிலான நேரடி, வழக்கமான CPU தொடங்கும் செயல்பாடுகளுக்கான பொதுவான மென்பொருள் இடைமுகம் மூலம் சேமிப்பக உள்ளீடு மற்றும் வெளியீட்டை சாம்சங்கின் AiSIO செயல்விளக்கம் கையாள்கிறது. OpenDS-ஐப் பயன்படுத்தி, வினாடிக்கு 100 மில்லியன் உள்ளீடு/வெளியீட்டுச் செயல்பாடுகளையும், தொடக்கத்தில் செயல்படாத நிலையிலிருந்து மொழி மாதிரிகளை ஏற்றுவதில் பத்து மடங்கு வரை வேகத்தையும் பெற்றதாக சாம்சங் தெரிவிக்கிறது.
இந்த அளவீடுகள் வெவ்வேறு பணிகளைக் குறிக்கின்றன. தொடர் வாசிப்பு வேகம் தொடர்ச்சியான தரவு பரிமாற்றத்தைக் குறிக்கிறது; வினாடிக்கு உள்ளீடு/வெளியீட்டுச் செயல்பாடுகள் சேமிப்பகக் கோரிக்கைகளின் எண்ணிக்கையைக் கணக்கிடுகின்றன; தொடக்க நிலையில் இருந்து ஏற்றும் நேரம், மாதிரி செயல்படத் தயாராகும் வேகத்தை அளவிடுகிறது. முழுமையான AI சேவை எத்தனை பயனர் கோரிக்கைகளைக் கையாளும் என்பதைக் காட்டும் செயல்திறன் மதிப்பீட்டுக்கு இவற்றில் எதுவும் நேரடி மாற்றாகாது.
வாடிக்கையாளர் சோதனைகளும் ஃபவுண்ட்ரி கண்காட்சிகளும் திட்டத்தை விரிவுபடுத்துகின்றன
வளர்ச்சியின் தொடக்கக் கட்டத்திலேயே வாடிக்கையாளர்களை ஈடுபடுத்துவதற்காக சாம்சங் MAX Lab அமைக்கப்பட்டுள்ளது. வணிகமயமாக்கலுக்கு முன், யதார்த்தமான AI பணிச்சுமைகளில் PIM, CMM-D, அடுத்த தலைமுறை SSD-கள் போன்ற தொழில்நுட்பங்களை வாடிக்கையாளர்கள் சோதிக்கலாம்; பின்னர் அமைப்புத் தேவைகளை தயாரிப்பு வடிவமைப்பில் தெரிவிக்கலாம்.
உச்சிமாநாட்டுச் செயல்விளக்கங்கள் முழுவதும் வெளிப்பட்ட ஒரு நடைமுறைச் சிக்கலை இந்த அணுகுமுறை கையாள்கிறது: மென்பொருளும் அதைச் சூழ்ந்துள்ள வன்பொருளும் பயன்படுத்திக்கொள்ள முடிந்தால்தான் வேகமான பாகம் பலனளிக்கும். சாம்சங்கின் Global Open-ecoSystem Team, திறந்த மூல மேம்பாடு மற்றும் தொழில்துறை தரநிலையாக்கத்தில் பங்கேற்கிறது. மென்பொருள் கட்டமைப்புகள், சேமிப்பகக் கட்டளைகளைக் கையாளுதல், நினைவக மேலாண்மை ஆகியவை குறித்த அமர்வுகளும் நிகழ்ச்சி நிரலில் இடம்பெற்றுள்ளன.
நிலையான NVMe வழியாக நேரடி இடமாற்றம் மற்றும் மெய்நிகர் SSD மேலாண்மையுடன் கலவையமைக்கக்கூடிய சேமிப்பகத்தையும் சாம்சங் செயல்விளக்கிக் காட்டியது. பல பயனர்கள் பகிர்ந்து கொள்ளக்கூடிய சேமிப்பகத்திற்கான வழியாக இதை நிறுவனத்தின் அதிகாரப்பூர்வ விளக்கம் முன்வைக்கிறது. ஒவ்வொரு பணிச்சுமைக்கும் கிடைக்கும் சேவையைக் கட்டுப்படுத்தும் சேவைத் தரக் கட்டுப்பாடுகளை இதில் அமல்படுத்தலாம்.
நினைவகத்தைத் தாண்டியும் கண்காட்சி விரிந்தது. சாம்சங் ஃபவுண்ட்ரியின் 4nm செயல்முறையில் தயாரிக்கப்பட்ட Groq மொழிச் செயலாக்க அலகு செதில்கள், பல செய்திக் குறிப்புகளில் Nvidia அமைப்பாகக் குறிப்பிடப்பட்ட Groq 3 LPX அமைப்பு, சாம்சங்கின் 2nm gate-all-around செயல்முறையைப் பயன்படுத்திய செதில்கள் ஆகியவை இடம்பெற்றதாகச் செய்திகள் தெரிவிக்கின்றன. இந்தக் கண்காட்சிகள் நினைவகம் மற்றும் சேமிப்பகத்துடன் உற்பத்தித் திறன்களையும் எடுத்துக்காட்டுகின்றன. ஆனால், புதிய உற்பத்தி ஒப்பந்தங்கள் அல்லது விநியோக அளவுகள் இருப்பதை இவை உறுதிப்படுத்தவில்லை.
பல மாதங்களாக வளர்ந்த கூட்டாண்மை
AMD செயல்விளக்கம், தனித்து நிகழ்ந்த ஒன்றல்ல; முந்தைய ஒத்துழைப்பின் தொடர்ச்சியாகும். அடுத்த தலைமுறை AI நினைவகம் மற்றும் கணினித் தொழில்நுட்பங்களை உள்ளடக்கிய புரிந்துணர்வு ஒப்பந்தத்தில் மார்ச் மாதம் கையெழுத்திட்டதாகவும், அதைத் தொடர்ந்து அக்டோபர் 7 அன்று AMD தலைமைச் செயல் அதிகாரி லிசா சூ தென் கொரியாவுக்கு வந்தபோது பேச்சுவார்த்தைகள் நடைபெற்றதாகவும் செய்திகள் தெரிவிக்கின்றன.
அறிக்கைகளில் தெரிவிக்கப்பட்ட நிகழ்வுகள் மற்றும் திட்டமிடப்பட்ட உச்சிமாநாட்டு அமர்வுகளின் வரிசை:
- மார்ச் 2026: சாம்சங்கும் AMD-யும் ஒத்துழைப்பு புரிந்துணர்வு ஒப்பந்தத்தில் கையெழுத்திட்டன; Nvidia GTC நிகழ்விலும் சாம்சங் தொழில்நுட்பத்தை முன்வைத்தது.
- ஜூன், ஆகஸ்ட் 2026: முறையே COMPUTEX மற்றும் Future of Memory and Storage மாநாட்டில் சாம்சங் பங்கேற்றது.
- அக்டோபர் 7, 2026: லிசா சூ தென் கொரியாவுக்கு வந்து, நினைவகம் மற்றும் கணினி ஒத்துழைப்பு குறித்து சாம்சங் DS பிரிவின் துணைத் தலைவர் ஜியோன் யங்-ஹியூனைச் சந்தித்தார்; ஃபவுண்ட்ரி தொடர்பான பேச்சுவார்த்தைகளும் நடைபெற்றதாகச் செய்திகள் தெரிவிக்கின்றன.
- அக்டோபர் 12, 2026: உச்சிமாநாடு தொடங்கியது; ஷிம்மின் நிர்வாக விளக்கக்காட்சி அன்றைக்கு திட்டமிடப்பட்டிருந்தது.
- அக்டோபர் 13 முதல் 15, 2026: KV கேச் படிநிலை அமைப்பு, சேமிப்பக மேம்படுத்தல், பகிரப்பட்ட CXL நினைவகக் கட்டமைப்பு குறித்த அமர்வுகள் சாம்சங்கின் நிகழ்ச்சித் திட்டத்தில் இடம்பெற்றன.
சாம்சங் வைர ஆதரவாளராகப் பங்கேற்றது. உத்தி அறிவிப்பை உள்ளூர் நேரப்படி அக்டோபர் 12-ஆம் தேதியுடன் இணைத்துக் கூறுவதா அல்லது நிறுவனத்தின் அக்டோபர் 13 அறிக்கையுடன் இணைப்பதா என்பதில் செய்திகளிடையே வேறுபாடு உள்ளது. இவ்விரு தேதிகளும் ஒரே நிகழ்வின் வெவ்வேறு கட்டங்களைக் குறிக்கலாம். ஒரு செய்தி உச்சிமாநாடு சான் பிரான்சிஸ்கோவில் நடைபெற்றதாகக் கூறுகிறது; சாம்சங்கின் அதிகாரப்பூர்வ அட்டவணையோ சான் ஜோஸ் மாநாட்டு மையத்தைக் குறிப்பிடுகிறது.
சந்தை அளவு வணிகத் தயார்நிலையை உறுதிப்படுத்தாது
2026-ஆம் ஆண்டின் இரண்டாம் காலாண்டில் உலக DRAM வருவாயில் 39% பங்குடனும், NAND ஃபிளாஷ் சந்தையில் 29.3% பங்குடனும் சாம்சங் முதலிடத்தில் இருந்ததாகத் தொழில்துறை ஆய்வு ஒன்று தெரிவிக்கிறது. DRAM புள்ளிவிவரத்துக்கு Counterpoint Research-உம், NAND புள்ளிவிவரத்துக்கு TrendForce-உம் ஆதாரங்களாகக் குறிப்பிடப்படுகின்றன. இவை சந்தைப் பங்கு அளவீடுகள்; வளர்ந்து வரும் CXL அல்லது நினைவகத்திலேயே செயலாக்கம் செய்யும் சந்தைகளின் பங்குகள் அல்ல.
அந்த ஆண்டில் தொழில்துறையிலேயே அதிக DRAM மற்றும் NAND செதில் உற்பத்தியை சாம்சங் மேற்கொள்ளும் என Omdia கணித்துள்ளதாகக் குறிப்பிடப்பட்டுள்ளது. 300mm செதில்களுக்கு இணையான அளவில், அதன் ஆண்டு DRAM திறன் சுமார் 8.175 மில்லியன் செதில்கள் என மற்றொரு மதிப்பீடு கூறுகிறது. உற்பத்தித் திறன் என்பது உண்மையான உற்பத்திக்கு இணையானதல்ல; மேலும், OCP-இல் காட்டப்பட்ட தொழில்நுட்பங்களுக்கு உற்பத்தியில் எவ்வளவு ஒதுக்கப்படும் என்பதையும் இந்த எண்கள் உறுதிப்படுத்தவில்லை.
அக்டோபர் 8 தேதியிட்ட, வழக்கத்திற்கு மாறாக அதிகமானதாகக் கூறப்படும் மூன்றாம் காலாண்டின் முன்னோட்ட எண்களையும் ஒரு செய்தி குறிப்பிடுகிறது: 195 டிரில்லியன் வோன் வருவாய், 107.4 டிரில்லியன் வோன் செயல்பாட்டு லாபம்; முந்தைய ஆண்டை விட லாபம் 782.5% உயர்வு. இங்கு அதிகாரப்பூர்வ நிதி அறிக்கையால் இந்த எண்கள் உறுதிப்படுத்தப்படவில்லை. உச்சிமாநாட்டுத் தொழில்நுட்பங்கள் ஈட்டிய வருமானத்துக்கான நிறுவப்பட்ட ஆதாரமாக இவற்றைக் கருதக் கூடாது.
HBM-ஐத் தாண்டியும் போட்டி விரிவடைகிறது. SK hynix-இன் Memory-Centric AI Rack System (MARS), ஒரு ரேக்கில் பகிரப்படும் CXL நினைவகத் திரட்டலாக இருப்பதாகச் செய்திகள் தெரிவிக்கின்றன. அமைப்புகள் முழுவதும் பயன்படுத்தப்படாத நினைவகத்தை அணுகக்கூடியதாக மாற்றும் சாம்சங்கின் முயற்சியுடன் இது ஒத்த அம்சங்களைக் கொண்டுள்ளது. எனினும், எந்த அணுகுமுறை சிறப்பாகச் செயல்படுகிறது என்பதை நிறுவுவதற்கான ஒப்பிடத்தக்க மதிப்பீடுகள் இல்லை.
HBM, சர்வர் DDR5, நிறுவனப் பயன்பாட்டு SSD ஆகியவற்றில் போட்டித்திறனை வலுப்படுத்துவதே சாம்சங் கூறும் நோக்கமாகும். HBM5 கிடைக்கும் காலம், விலை, பரந்த அளவிலான வாடிக்கையாளர் பயன்பாடு, செயல்திறன் கூற்றுகளுக்கான சுயாதீன உறுதிப்படுத்தல் ஆகியவை இன்னும் தீர்மானிக்கப்படாத வணிக விவரங்களாக உள்ளன. உச்சிமாநாட்டு நிகழ்ச்சித் திட்டம் செயல்விளக்கம் மற்றும் விவாதங்களுக்கான தேதிகளை வழங்குகிறது; ஒவ்வொரு தொழில்நுட்பத்துக்குமான உறுதியான வெளியீட்டுக் காலக்கெடுவை அல்ல.
முக்கிய அம்சங்கள்
- சாம்சங்கின் OCP 2026 உத்தி, வேகமான நினைவகம், CXL திறன் விரிவாக்கம், தரவைத் தக்கவைக்கும் SSD சேமிப்பகம் ஆகியவற்றை ஒருங்கிணைக்கிறது.
- AI நினைவகத் தேவை அதிகரிப்பைக் கையாள, AMD உடனான ஒத்துழைப்பில் CMM-D நினைவகத் தொழில்நுட்பம் பயன்படுத்தப்படுகிறது.
- தனியான மீள்திறன் நினைவகத் திரட்டல் செயல்விளக்கத்தில், முதல் டோக்கனுக்கான நேரம் 38% வரை குறைந்ததாகவும், பயனுள்ள செயலாக்க அளவு 3.3 மடங்கு அதிகரித்ததாகவும் தெரிவிக்கப்பட்டுள்ளது.
- சாம்சங் எட்ஜ் AI முடுக்கியில் LPDDR5X-PIM மதிப்பீட்டின் ஊகச் செயல்திறன் மூன்று மடங்கு வரை அதிகரித்துள்ளது.
- PM1763 சேமிப்பகம், KV கேச் மேம்படுத்தல், SSD-களுக்குள் கணக்கீடு ஆகியவை தரவு நகர்வில் உள்ள வெவ்வேறு தடைகளைக் கையாள்கின்றன.
- HBM5 விநியோகத் தேதிகளையும் பரந்த அளவிலான வணிகக் கிடைப்பையும் உச்சிமாநாட்டு அறிவிப்புகள் உறுதிப்படுத்தவில்லை.