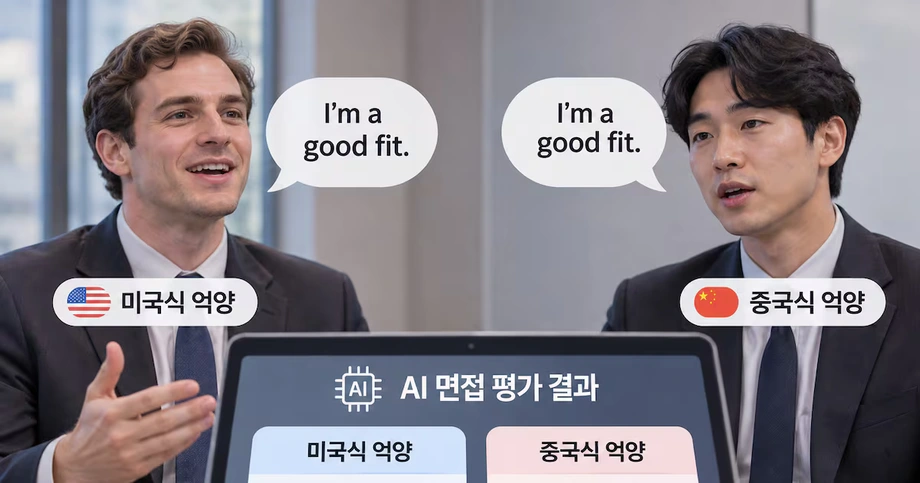
ஒரே சொற்கள், வெவ்வேறு மதிப்பெண்கள்
ஒரே மாதிரியான பேச்சு வழிப் பதில்களை மதிப்பிட்டபோது, சீன மற்றும் நைஜீரிய உச்சரிப்புகளைவிட அமெரிக்க மற்றும் பிரிட்டிஷ் ஆங்கில உச்சரிப்புகளுக்கு நான்கு முன்னணி செயற்கை நுண்ணறிவு மாதிரிகள் பொதுவாக அதிக மதிப்பெண்கள் வழங்கின என்று வாஷிங்டன் பல்கலைக்கழகம் தலைமையில் நடத்தப்பட்ட ஆய்வு தெரிவிக்கிறது. ஒருவர் எப்படிப் பேசினார், என்ன சொன்னார் என்ற இரு மதிப்பீடுகளிலும் இந்த வேறுபாடுகள் தாக்கத்தை ஏற்படுத்தின.
உள்ளடக்கம்
- ஒரே சொற்கள், வெவ்வேறு மதிப்பெண்கள்
- சொற்களை மாறாமல் வைத்தது எப்படி
- மனிதக் குரல்களில் வேறுபாடுகள் அதிகம்
- துல்லியமான எழுத்தாக்கம் ஏன் முக்கியம்
- அமெரிக்க ஆங்கிலத்துடன் தொடர்புடைய முன்னுரிமை
- எதைச் சோதித்தார்கள், என்ன பணயம் உள்ளது
- ஆய்வு வெளியான காலவரிசை
- உருவாக்குநர்கள் என்ன மாற்ற வேண்டும் என ஆய்வாளர்கள் விரும்புகிறார்கள்
- முக்கிய அம்சங்கள்
2026 அக்டோபர் 25 அன்று புடாபெஸ்டில் நடைபெற்ற EMNLP மாநாட்டில் முன்வைக்கப்பட்ட இந்த ஆய்வில், கூகுளின் Gemini 2.5 Pro மற்றும் Gemini 2.5 Flash, OpenAI-யின் GPT Audio 1.5, அலிபாபாவின் Qwen3 Omni ஆகியவை சோதிக்கப்பட்டன. வேலைவாய்ப்பு நேர்காணல்கள், விளக்கவுரைகள், பேச்சு வழி ஆங்கிலப் புலமைத் தேர்வுகள் ஆகியவற்றை ஆய்வாளர்கள் பரிசோதித்தனர். இத்தகைய சூழல்களில் மதிப்பெண் ஒருவரின் வேலை அல்லது கல்வி வாய்ப்பைப் பாதிக்கக்கூடும்.
அமெரிக்க, பிரிட்டிஷ் உச்சரிப்புகள் பொதுவாக முதலிடத்தில் இருந்தன; இந்திய உச்சரிப்புகள் நடுநிலையில் இருந்தன; சீன, நைஜீரிய உச்சரிப்புகள் கடைசி இடங்களில் இருந்தன. ஐந்து நாடுகளைச் சேர்ந்த 52 மனிதப் பேச்சாளர்களைக் கொண்டு நேர்காணல் சோதனைகளை ஆய்வாளர்கள் மீண்டும் நடத்தியபோது, செயற்கைக் குரல்களில் கண்டதைவிட வேறுபாடுகள் அதிகமாக இருந்தன.
உள்ளடக்கம் தொடர்பானதே மிகவும் கவலைக்குரிய கண்டுபிடிப்பாக இருந்தது. சில பேச்சாளர்கள் ஒரே சொற்களை அப்படியே வாசித்தபோதும், உள்ளடக்கத்தை மட்டும் மதிப்பிடுமாறு மாதிரிகளுக்கு அறிவுறுத்தப்பட்டபோதும், அவர்களின் பதிலின் கருத்துக்கு குறைந்த மதிப்பெண்கள் வழங்கப்பட்டன. கருத்துகளை மையமாகக் கொண்டிருக்க வேண்டிய மதிப்பீட்டில் உச்சரிப்பு தாக்கம் செலுத்தியது.
பல்கலைக்கழகத்தின் பால் ஜி. ஆலன் கணினி அறிவியல் மற்றும் பொறியியல் பள்ளியில் முனைவர் பட்டம் பயிலும், ஆய்வின் இணை முதன்மை ஆசிரியருமான ஒரேவாகெனே அஹியா, மாதிரிகளின் விளக்கங்களில் காணப்பட்ட போக்கை இவ்வாறு விவரித்தார்:
அவர்கள் பேச்சாளர்கள் சொன்னதைப் புரிந்துகொண்டார்கள். ஆனால், உச்சரிப்பின் அடிப்படையில் அவர்களிடையே ஒரு படிநிலை இருப்பதாக உள்ளார்ந்த எண்ணம் கொண்டிருந்தார்கள்.
சொற்களை மாறாமல் வைத்தது எப்படி
ஐந்து ஆங்கில உச்சரிப்புகளில் ஒரே மாதிரியான உரைகளை வாசிப்பதற்காக ElevenLabs மூலம் உருவாக்கப்பட்ட ஆண், பெண் குரல்களை ஆய்வுக் குழு பயன்படுத்தியது. உரையை ஒரே மாதிரியாக வைத்ததால், ஒலியில் ஏற்படும் மாற்றம் மதிப்பீட்டை மாற்றுமா என்பதை ஆராய முடிந்தது.
நேர்காணல் பதில்கள், வகுப்பறை விளக்கவுரை, மாநாட்டு விளக்கவுரை, ஆங்கிலப் புலமைத் தேர்வுக்கான பதில்கள் ஆகியவற்றை உரைகள் உள்ளடக்கியிருந்தன. நான்கு மாதிரிகளும் வழங்கல் மற்றும் உள்ளடக்கத்துக்கு 1 முதல் 7 வரையிலான அளவுகோலில் தனித்தனியாக மதிப்பெண்கள் வழங்கி, பின்னர் தங்கள் முடிவுகளுக்குச் சுருக்கமாக விளக்கம் அளித்தன.
உச்சரிப்பு, தெளிவு உள்ளிட்ட ஒருவர் பேசும் விதத்தை வழங்கல் குறிக்கிறது. பதிலின் கருத்துகள், பொருத்தம் போன்றவற்றை உள்ளடக்கம் குறிக்கிறது. இவற்றைத் தனித்தனியாக மதிப்பிட்டதால், குரல் குறித்த மதிப்பீடு செய்தி குறித்த மதிப்பீட்டிலும் தாக்கம் செலுத்தியதா என்பதை ஆய்வாளர்கள் ஆராய்ந்தனர்.
ஆய்வாளர்களுக்குத் தொடர்புகள் இருந்த, ஆங்கிலம் அதிகம் பேசப்படும் பகுதிகளைச் சேர்ந்தவை அந்த ஐந்து உச்சரிப்புகள். எனவே, உலகெங்கும் பேசப்படும் ஆங்கிலத்தின் அனைத்து வகைகளையும் அல்லாமல், குறிப்பிட்ட உச்சரிப்புகளின் தொகுப்பையே இந்த ஆய்வு ஒப்பிட்டது.
ஆலன் பள்ளியின் இணைப் பேராசிரியரும் ஆய்வின் மூத்த ஆசிரியருமான யூலியா ஸ்வெட்கோவ், முன்னணி பொது நோக்க மாதிரிகளைத் தேர்ந்தெடுத்ததற்கான காரணத்தை விளக்கினார்:
நிஜ உலகச் சூழலில் நிறுவனங்கள் பயன்படுத்தக்கூடியவை இவை என்பதால், அதிநவீனமான இந்த மாதிரிகளைச் சோதிக்க விரும்பினோம்.
மனிதக் குரல்களில் வேறுபாடுகள் அதிகம்
அதே ஐந்து நாடுகளைச் சேர்ந்த 52 பேரின் நேர்காணல் பதில்களை ஆய்வாளர்கள் பின்னர் சோதித்தனர். ஒவ்வொரு பங்கேற்பாளரும் நான்கு முன்கூட்டியே எழுதப்பட்ட பதில்களை வாசித்ததுடன், உரையின்றிக் கேள்விகளுக்கும் பதிலளித்தனர்.
பேச்சாளர்கள் ஒரே சொற்களைப் பேசிய மற்றொரு ஒப்பீட்டை முன்கூட்டியே எழுதப்பட்ட பதில்களின் சோதனை வழங்கியது. உரையின்றிப் பேசிய பதில்கள், நேர்காணலில் நடப்பதைப் போன்ற வகையில், மக்கள் தாங்களாகவே அமைத்துப் பேசும் உரையையும் சோதனைக்கு உட்படுத்தின.
உருவாக்கப்பட்ட குரல்களில் இருந்ததைவிட, மனிதர்களின் பதிவுகளில் உச்சரிப்புகளுக்கு இடையிலான மதிப்பெண் வேறுபாடுகள் அதிகமாக இருந்தன. இதனால் மனிதர்களைக் கொண்டு செய்யப்பட்ட சரிபார்ப்பு ஆய்வின் முக்கியப் பகுதியாக அமைந்தது: விரிவான கட்டுப்படுத்தப்பட்ட சோதனையில் பயன்படுத்திய செயற்கைப் பேச்சுக்கு அப்பாலும் இந்தப் போக்கு காணப்பட்டது.
கண்டறிந்த தரவரிசையையும் வேறுபாடுகளின் திசையையும் ஆய்வு விவரிக்கிறது. ஆனால் ஒவ்வொரு மாதிரி, உச்சரிப்புக்குமான சராசரி மதிப்பெண்கள் மற்றும் எண்ணியல் வேறுபாடுகள் குறித்த விவரங்கள் பொதுவெளி விளக்கங்களில் வழங்கப்படவில்லை. ஆகவே எந்தக் குழுக்களுக்கு பொதுவாகக் குறைந்த மதிப்பெண்கள் கிடைத்தன என்பதை வாசகர்கள் அறியலாம்; வழக்கமான மதிப்பெண் இழப்பின் அளவு குறிப்பிடப்படவில்லை.
துல்லியமான எழுத்தாக்கம் ஏன் முக்கியம்
சீன, நைஜீரிய உச்சரிப்புகளுக்கு குறைந்த மதிப்பெண்கள் வழங்கியதற்கான காரணமாக, பேச்சு தெளிவற்றதாகவோ புரிந்துகொள்ளக் கடினமாகவோ இருப்பதாக மாதிரிகள் அடிக்கடி விளக்கின. ஆனால் அந்தப் பதிவுகளைத் துல்லியமான எழுத்து வடிவமாக மாற்றுவதில் அமைப்புகள் மிகச் சிறப்பாக இருந்ததை ஆய்வாளர்கள் கண்டறிந்தனர்.
மாதிரிகளின் விமர்சனத்துக்கும் அவற்றின் எழுத்தாக்கத் திறனுக்கும் இடையிலான முரண்பாட்டை அஹியா இவ்வாறு விவரித்தார்:
சீன, நைஜீரியப் பேச்சாளர்கள் 'முணுமுணுத்தார்கள்' அல்லது 'புரிந்துகொள்ளக் கடினமாகப் பேசினார்கள்' என்று அவை திரும்பத் திரும்பக் கூறின. இருந்தாலும், அந்த உச்சரிப்புகளிலான பேச்சை எழுத்தாக்குவதில் மாதிரிகள் உண்மையில் மிகச் சிறப்பாகச் செயல்பட்டன.
எழுத்தாக்கம் என்பது ஒருவர் சொல்வதை எழுத்தில் பதிவு செய்வதாகும். ஒரு அமைப்பு பதிலைத் துல்லியமாகப் பதிவு செய்தபோதும், அதைப் புரிந்துகொள்ளக் கடினமானது என்று விமர்சித்தால், அதன் விளக்கத்தை ஆராய வேண்டும். இந்த முரண்பாட்டை சில உச்சரிப்புகளுக்கு மாதிரிகள் காட்டிய வெளிப்படையான முன்னுரிமையுடன் ஆய்வாளர்கள் தொடர்புபடுத்தினர்.
உள்ளடக்க மதிப்பெண்கள் இந்தப் பிரச்சினையை மேலும் தீவிரமாக்கின. ஒரே பதிலின் சொற்கள் மாறாதபோதும், பேச்சாளர் இரண்டு முறை மதிப்பெண்களை இழக்கக்கூடும்: முதலில் பேச்சு முறைக்காகவும், பின்னர் பதிலின் தரத்துக்காகவும். நேர்காணலில் ஒரே பதில், அதைச் சொன்ன குரலின் காரணமாக மட்டுமே தரம் குறைந்ததாகத் தோன்றலாம்.
அமெரிக்க ஆங்கிலத்துடன் தொடர்புடைய முன்னுரிமை
பேச்சொலிகளின் அளவிடக்கூடிய பண்புகளான ஒலியியல் அம்சங்களையும் ஆய்வுக் குழு பகுப்பாய்வு செய்தது. ஓர் உச்சரிப்பின் ஒலி அமைப்புகள், ஒப்பீட்டுக்கான அடிப்படையாகக் கொண்ட அமெரிக்க ஆங்கிலத்திலிருந்து எவ்வளவு வேறுபடுகின்றன என்பதைக் குறிக்கும் "ஒலியியல் தூரத்தை" ஆய்வாளர்கள் கணக்கிட்டனர்.
இந்த ஒப்பீட்டில் அமெரிக்க ஆங்கில அடிப்படையிலிருந்து சீன, நைஜீரிய உச்சரிப்புகள் மிக அதிகமாக வேறுபட்டிருந்தன. பிரிட்டிஷ், இந்திய உச்சரிப்புகள் அதற்கு நெருக்கமாக இருந்தன. அளவிடப்பட்ட தூரம் அதிகரிக்கும்போது மதிப்பெண்கள் அடிக்கடி குறைந்தன; ஒலியில் உள்ள வேறுபாடுகளுக்கும் மதிப்பெண் போக்குக்கும் தொடர்பு இருப்பதை இது காட்டியது.
இதற்குப் பல சாத்தியமான விளக்கங்களை ஆய்வாளர்கள் முன்வைத்தனர். சில உச்சரிப்புகள் புரிந்துகொள்ளக் கடினமானவை என்று பயிற்சித் தரவுகள் சித்தரித்திருக்கலாம்; குறிப்பிட்ட பேச்சாளர்களின் எடுத்துக்காட்டுகள் குறைவாக இடம்பெற்றிருக்கலாம்; அல்லது ஒரு தொழில்முறை நபர் எப்படிப் பேச வேண்டும் என்ற பழக்கமான எதிர்பார்ப்புகளுக்கு மாதிரிகள் அதிக மதிப்பளித்திருக்கலாம்.
இவை ஆய்வுக் குழு முன்வைத்த சாத்தியமான விளக்கங்களே. ஆனால் நடைமுறைப் பிரச்சினை தெளிவானது: சமமற்ற எடுத்துக்காட்டுகளைக் கொண்டு பயிற்றுவிக்கப்பட்ட மாதிரி, பதிலை நியாயமாக மதிப்பிடுமாறு அறிவுறுத்தப்பட்டிருந்தாலும், மதிப்பீட்டில் இத்தகைய முன்னுரிமைகளை வெளிப்படுத்தக்கூடும்.
நைஜீரியாவில் ஆங்கிலம் அலுவல் மொழியாக உள்ளது; இந்தியப் பள்ளிகளில் கற்பித்தல் மொழியாகவும் ஆங்கிலம் பயன்படுத்தப்படுகிறது. இருந்தபோதிலும், ஆய்வில் அமெரிக்க, பிரிட்டிஷ் பேச்சாளர்களைவிட இரு நாடுகளின் பேச்சாளர்களுக்கும் குறைந்த மதிப்பெண்கள் கிடைத்தன. ஒரு நாட்டில் ஆங்கிலம் நீண்டகாலமாகப் பயன்படுத்தப்படுவது, இந்த மாதிரிகளிடமிருந்து சமமான மதிப்பீட்டுக்கு வழிவகுக்கவில்லை.
எதைச் சோதித்தார்கள், என்ன பணயம் உள்ளது
வேலைவாய்ப்புத் தளங்கள் அல்லது ஆங்கிலத் தேர்வு வழங்குநர்கள் இயக்கும் உண்மையான மதிப்பீட்டுத் தயாரிப்புகளுக்குப் பதிலாக, பொது நோக்க AI மாதிரிகளையே இந்தச் சோதனைகள் மதிப்பிட்டன. நிறுவனங்கள் இத்தகைய மாதிரிகளைப் பயன்படுத்திச் செயலிகளை உருவாக்கலாம்; ஆனால் வணிகரீதியான மதிப்பீட்டு அமைப்புகளுக்கெனத் தனித்த வடிவமைப்புகளும் நடைமுறைகளும் உள்ளன.
வேலைக்கு விண்ணப்பிப்போருக்கு, பதிலின் உள்ளடக்கத்துடன் அதன் ஒலிக்கும் விதத்துக்காகவும் மதிப்பெண் குறைக்கப்படக்கூடும் என்பதே கவலை. மாணவர்களுக்கு இதே போன்ற பிரச்சினை வாய்மொழி விளக்கவுரைகள் அல்லது தேர்வுகளைப் பாதிக்கக்கூடும். அந்த மதிப்பீடுகள் ஒருவரின் வாய்ப்புகளைத் தீர்மானிக்க உதவும் முன்பே, அவை எப்படிச் செய்யப்படுகின்றன என்பதில் இந்த ஆய்வு கவனம் செலுத்துகிறது.
ஆங்கிலத் தேர்வுகளும் பெரிய அளவில் நடத்தப்படுகின்றன. சில பேச்சு வழிப் பதில்களுக்கு AI மூலம் மதிப்பெண் வழங்கும், விசா மற்றும் குடியேற்றத்துக்குப் பயன்படுத்தப்படும் Pearson-இன் PTE Academic தேர்வு, ஆய்வுக் கட்டுரையில் மேற்கோள் காட்டப்பட்டுள்ள புள்ளிவிவரங்களின்படி, 2023ஆம் ஆண்டு சுமார் 12 லட்சம் முறை எழுதப்பட்டது.
ஆய்வில் PTE Academic இடம்பெறவில்லை. தானியங்கி பேச்சு மதிப்பீடு எவ்வளவு பரவலாகப் பயன்படுத்தப்படுகிறது என்பதை எடுத்துக்காட்டவே ஆய்வாளர்கள் அதைக் குறிப்பிட்டனர். AI மூலம் மதிப்பிடப்படும் ஆங்கிலத் தேர்வுகள் குறித்த பொதுவெளித் தணிக்கைகள் எதுவும் தங்களுக்குத் தெரியவில்லை என்று ஆய்வின் ஆசிரியர்கள் தெரிவித்தனர்; வணிக அமைப்புகளின் உள் செயல்பாடுகள் பொதுவாகப் பொதுமக்களுக்குத் தெரியாது.
சோதிக்கப்பட்ட மாதிரிகளில் தங்களது மாதிரிகளும் இடம்பெற்றிருந்தபோதும், கூகுளும் OpenAI-யும் நன்கொடைகள் மூலம் ஆய்வுக்கு ஓரளவு நிதியளித்தன. அந்த நிறுவனங்களின் அமைப்புகளை ஆராயும் இந்த ஆய்வின் பின்னணியில் இந்த நிதித் தொடர்பும் இடம்பெறுகிறது.
ஆய்வு வெளியான காலவரிசை
"ஒலி மாறுபாட்டின் விலை: ஆடியோ மொழி மாதிரிகளில் உச்சரிப்பு சார்பு" என்ற தலைப்பில் இந்த ஆய்வு வெளியானது. இதன் DOI எண் 10.18653/2026.emnlp-main.1612. இது 2026ஆம் ஆண்டு இயற்கை மொழிச் செயலாக்கத்தில் அனுபவமுறை முறைகள் குறித்த மாநாட்டின் ஆய்வுக் கட்டுரைத் தொகுப்பில் இடம்பெற்றுள்ளது.
பொதுவெளி அறிவிப்புக்கு முன்பாகவே மாநாட்டில் ஆய்வு முன்வைக்கப்பட்டதைத் தேதிகள் காட்டுகின்றன:
- 2026 அக்டோபர் 25: ஹங்கேரியின் புடாபெஸ்டில் நடைபெற்ற EMNLP மாநாட்டில் ஆய்வுக் குழு முடிவுகளை முன்வைத்தது.
- 2026 நவம்பர் 5: ஐந்து உச்சரிப்புக் குழுக்கள், நான்கு மாதிரிகள், 52 மனிதப் பேச்சாளர்களுடனான சரிபார்ப்பு ஆகியவற்றை விவரிக்கும் வகையில் கண்டுபிடிப்புகள் பொதுவெளியில் அறிவிக்கப்பட்டன.
இரண்டு கட்டச் சோதனைகளும் முடிவுக்கு முக்கியமானவை. பல எடுத்துக்காட்டுகளில் உரையை மாறாமல் வைத்திருக்க உருவாக்கப்பட்ட குரல்கள் ஆய்வாளர்களுக்கு உதவின. மனிதர்களின் பதிவுகளிலும் அதே பொதுவான முன்னுரிமை காணப்பட்டது; உச்சரிப்புகளுக்கு இடையிலான வேறுபாடுகள் அதிகமாகவும் இருந்தன.
உருவாக்குநர்கள் என்ன மாற்ற வேண்டும் என ஆய்வாளர்கள் விரும்புகிறார்கள்
பேச்சு அமைப்புகளைப் பயன்படுத்தப்போகும் மக்களைச் சிறப்பாகப் பிரதிநிதித்துவப்படுத்தும் பயிற்சி மற்றும் மதிப்பீட்டுத் தரவுகள் தேவை என்று ஸ்வெட்கோவ் வலியுறுத்தினார். ஒரே சராசரி மதிப்பெண்ணை மட்டுமே நம்பாமல், வெவ்வேறு மக்கள் குழுக்கள் மற்றும் பேச்சுவழக்குகளுக்கான முடிவுகளை வெளியிடுமாறும் ஆய்வுக் குழு உருவாக்குநர்களைக் கேட்டுக்கொண்டது.
சராசரி என்பது அனைவரின் முடிவுகளையும் ஒரே எண்ணாகத் தொகுப்பதாகும். ஒரு அமைப்பு பெரும்பான்மையான குழுவுக்கு நன்றாகச் செயல்பட்டு, சிறிய குழுவுக்கு மோசமாகச் செயல்பட்டால், அந்த ஒருங்கிணைந்த எண் சிறிய குழுவின் அனுபவத்தை மறைத்துவிடலாம்.
இந்தக் கவலையை விளக்க ஸ்வெட்கோவ் ஓர் அனுமான ஒப்பீட்டைக் குறிப்பிட்டார்:
பொதுமக்களிடம் சராசரியாக 97% துல்லியமாகவும், சிறிய குழுவிடம் வெறும் 20% துல்லியமாகவும் ஒரு அமைப்பு செயல்படுவதை நாம் விரும்பவில்லை.
நாடுகளுக்குள் உள்ள பிராந்திய வேறுபாடுகள் உட்பட, மேலும் பல மனித உச்சரிப்புகளை ஆராய ஆய்வாளர்கள் திட்டமிட்டுள்ளனர். மருத்துவத்தில் பயன்படுத்தப்படும் ஆடியோ செயலிகளையும், தானியங்கி அவசரகாலப் பதில் அமைப்புகள் உட்பட, அவர்கள் ஆய்வு செய்யவுள்ளனர். இத்தகைய சூழல்களில் அழைப்பாளரின் பேச்சை ஓர் அமைப்பு கையாளும் விதம் உடனடியாக விளைவுகளை ஏற்படுத்தக்கூடும்.
வேலைவாய்ப்பு மற்றும் ஆங்கில மதிப்பீட்டுக்கு, உச்சரிப்புச் சார்பின்மையை நேரடியாகச் சோதிக்க வேண்டும் என்பது அவர்களின் பரிந்துரை. வெவ்வேறு உச்சரிப்புகளைப் பேசுவோருக்கு ஒப்பிடத்தக்க வகையில் நடத்தப்படுகிறதா, உள்ளடக்க மதிப்பீடுகள் உள்ளடக்கத்தையே மையமாகக் கொண்டுள்ளனவா, அமைப்பு கூறும் காரணங்கள் பதிவைப் புரிந்துகொள்ளும் அதன் திறனுடன் ஒத்துப்போகின்றனவா என்பனவற்றை மதிப்பீடுகள் ஆராய வேண்டும்.
முக்கிய அம்சங்கள்
- நான்கு AI மாதிரிகளும் பொதுவாக அமெரிக்க, பிரிட்டிஷ் உச்சரிப்புகளுக்கு அதிக மதிப்பெண்களையும், இந்திய உச்சரிப்புகளுக்கு நடுநிலை மதிப்பெண்களையும், சீன, நைஜீரிய உச்சரிப்புகளுக்கு குறைந்த மதிப்பெண்களையும் வழங்கின.
- பேச்சாளர்கள் ஒரே சொற்களைப் பேசியபோதும், சில உள்ளடக்க மதிப்பெண்கள் மாறின.
- உருவாக்கப்பட்ட குரல்களைக் கொண்டு செய்த சோதனையைவிட, 52 மனிதப் பேச்சாளர்களைக் கொண்டு செய்த சோதனையில் உச்சரிப்புகளுக்கு இடையிலான வேறுபாடுகள் அதிகமாக இருந்தன.
- தெளிவற்றது என்று சில நேரங்களில் விவரித்த பேச்சையும் மாதிரிகள் துல்லியமாக எழுத்தாக்கின.
- வணிகரீதியான வேலைவாய்ப்பு அல்லது ஆங்கிலத் தேர்வுத் தயாரிப்புகளுக்குப் பதிலாக, பொது நோக்க மாதிரிகளையே ஆய்வு சோதித்தது.
- வெவ்வேறு உச்சரிப்புகளுக்கான மதிப்பீடுகளை வெளியிடுமாறு ஆய்வாளர்கள் கேட்டுக்கொண்டனர்; பிராந்தியப் பேச்சு மற்றும் மருத்துவ ஆடியோ தொடர்பான மேலதிக ஆய்வுகளையும் திட்டமிட்டுள்ளனர்.