செயல்படும் GPU மற்றும் 5% செயல்திறன் அதிகரிப்பு குறித்த கூற்று
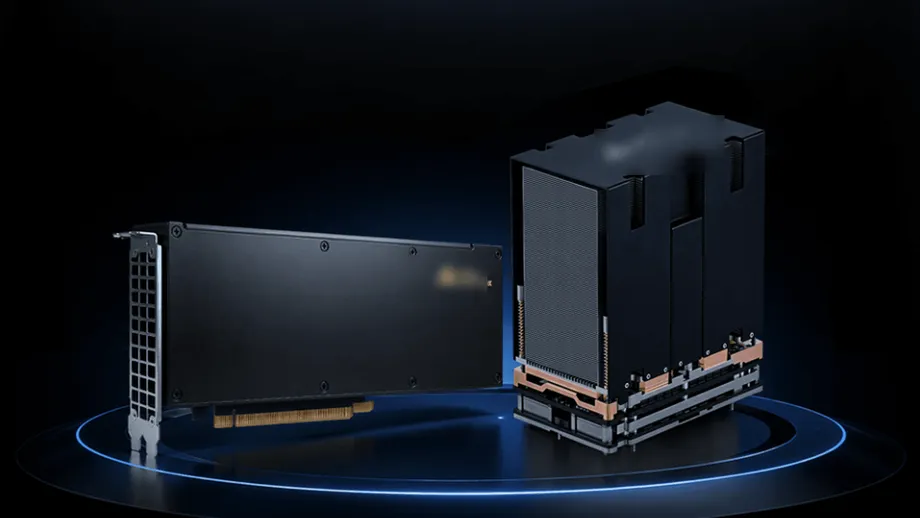
ஷாங்காயில் தனது Tiangai 300 கிராபிக்ஸ் செயலியைப் பொதுவெளியில் செயல்விளக்கம் செய்து, Nvidia-வின் H200-க்கு சீன மாற்றாக அதை Iluvatar CoreX அறிமுகப்படுத்தியது. மூன்றாம் தரப்பினர் நடத்திய ஊகக்கணிப்புச் சோதனையில் 5% முன்னிலை பெற்றதாகவும் அந்நிறுவனம் கூறியது. 2026 அக்டோபர் 28 அன்று நடைபெற்ற ஊடகத் திறந்தநாள் நிகழ்வில், எட்டு GPU-களைக் கொண்ட பயிற்சி அமைப்பையும், 144 GPU-களும் 18 CPU-களும் உள்ள ரேக் அமைப்பையும் அது காட்டியது.
உள்ளடக்கம்
- செயல்படும் GPU மற்றும் 5% செயல்திறன் அதிகரிப்பு குறித்த கூற்று
- H200 ஒப்பீடு எதை அளவிடுகிறது
- நீண்ட ஆவணங்களும் விரைவான முதல் பதில்களும்
- பயிற்சி முடிவுகளுக்கு வேறொரு Nvidia ஒப்பீடு
- ஜூலை அறிமுகத்திலிருந்து அக்டோபர் செயல்விளக்கம் வரை
- 144 GPU-களை மையமாகக் கொண்ட ரேக்
- வெவ்வேறு சிப்களிடையே AI பணிகளைப் பகிர்தல்
- பயன்பாட்டுக்கான நேரத்தைக் குறிவைக்கும் மென்பொருள் கூற்றுகள்
- ரோபோக்களுக்கான முன்மொழிவை விரிவாக்கும் TY1200
- முக்கிய அம்சங்கள்
இந்த முக்கிய ஒப்பீடு, Iluvatar CoreX-இன்படி, ஜூலை மாதம் Shanghai Electric Group நடத்திய சோதனையை அடிப்படையாகக் கொண்டது. பெரிய மொழி மாதிரிச் செயலாக்கத்தின் இரு நிலைகளையும் பிரித்த அமைப்பில், சோதனை முடிவுகளை ஒவ்வொரு அட்டைக்குமான மதிப்பாக மாற்றியபோது, Tiangai 300-இன் தொடக்கம் முதல் முடிவு வரையிலான செயல்திறன் H200-இன் 1.05 மடங்குக்குச் சமமாக இருந்தது.
செயல்திறன் என்பது ஒரு குறிப்பிட்ட காலத்தில் ஓர் அமைப்பு முடிக்கும் பயனுள்ள வேலையின் அளவைக் குறிக்கிறது. சாட்பாட்டைப் பொறுத்தவரை, ஒவ்வொரு நொடியும் அது உருவாக்கும் உரையின் அளவாக இது இருக்கலாம். சோதனையின் நிபந்தனைகளில் குறிப்பு செயல்திறனைவிட 1.05 மடங்கு முடிவு என்பது 5% கூடுதல் வெளியீட்டைக் குறிக்கிறது.
அளவிடப்பட்ட சோதனையில் H200 செயல்திறனை எட்டிய முதல் சீனப் பொதுப் பயன்பாட்டு GPU Tiangai 300 என அந்நிறுவனம் விவரித்தது. அக்டோபர் செயல்விளக்கத்தில் மொழி மாதிரிகள், பட உருவாக்கம், காணொளி உருவாக்கம் ஆகியவற்றுக்கான ஒப்பீடுகளையும் அது காட்டியது. தனியாக நடைபெற்ற பயிற்சிச் செயல்விளக்கத்தில் Nvidia H100 ஒப்பீட்டு அடிப்படையாகப் பயன்படுத்தப்பட்டது.
இந்த நிகழ்வு சிப் விவரக்குறிப்புகளை மட்டும் முன்வைக்கவில்லை. அட்டைகள், சர்வர்கள், அதிக அடர்த்தியுள்ள ரேக் வடிவமைப்பு, மென்பொருள் கருவிகள், வெவ்வேறு வகை செயலிகளுக்கிடையே AI பணிகளைப் பகிரும் முறை ஆகியவற்றையும் Iluvatar CoreX காட்சிப்படுத்தியது. இந்தக் கூறுகள் குறைந்த செலவில், குறைந்த காத்திருப்புடன் பயனுள்ள AI வெளியீட்டை வழங்கும் என்பதே அதன் வணிக முன்மொழிவு.
H200 ஒப்பீடு எதை அளவிடுகிறது
Shanghai Electric Group-இன் ஜூலை சோதனையில், பெரும்பாலும் PD பிரிப்பு என்று சுருக்கமாக அழைக்கப்படும் prefill மற்றும் decode பிரிப்பு பயன்படுத்தப்பட்டது. ஒரு மொழி மாதிரி பயனரின் கோரிக்கையையும் அதற்கான ஆதாரப் பொருளையும் வாசிக்கும் நிலை prefill ஆகும். அது ஒவ்வொரு token-ஆகப் பதிலை உருவாக்கும் நிலை decode ஆகும். AI அமைப்புகள் உரையைப் பிரிக்கும் சிறிய அலகுகளே token-கள்.
இந்த நிலைகளைப் பிரிப்பதன் மூலம், வாசிப்புக்கும் எழுதுவதற்கும் வளங்களை வெவ்வேறாக ஒதுக்கலாம். எனவே Tiangai 300-இன் முடிவு, ஒரு குறிப்பிட்ட செயலாக்க அமைப்பைப் பற்றியது; மொத்தச் செயல்திறன் ஒற்றை அட்டைக்கான சமமான மதிப்பாக வெளிப்படுத்தப்பட்டுள்ளது.
மூன்றாம் தரப்பு சோதனையின் முக்கிய முடிவுக்குப் பின்னுள்ள விரிவான சோதனை முறை, மாதிரிப் பட்டியல் அல்லது பணிச்சுமை நிலைமைகளை Iluvatar CoreX வெளியிடவில்லை. சுயாதீனமாகச் சோதனையை மீண்டும் நடத்த, அந்த விவரங்களுடன் மதிப்பு மாற்றக் கணக்கீடும் மென்பொருள் அமைப்புகளும் தேவை. செலவு ஒப்பீட்டுக்கான விரிவான கணக்கீடும் வெளியிடப்படவில்லை. தனிப்பட்ட அட்டைகளின் நினைவக அளவுகளுக்கும் முழு ரேக்கின் நினைவக அளவுக்கும் தெளிவுபடுத்தல் தேவை.
செயல்திறன் ஆய்வகத்தின் பெயரிடப்பட்ட செயல்விளக்கங்கள், நிறுவனத்தின் கூற்றுகள் குறித்த விரிவான படத்தை அளிக்கின்றன. பன்மாதிரி உருவாக்கத்தில் சிறிய உயர்வு முதல் பரிந்துரைச் செயல்திறனில் பெரிய அதிகரிப்பு வரை, வெவ்வேறு பணிகளுக்கான வெவ்வேறு மேம்பாடுகள் அவற்றில் விவரிக்கப்பட்டுள்ளன. வாங்குபவரைப் பொறுத்தவரை, தங்கள் சேவை உண்மையில் இயக்கும் பணியுடன் ஒப்பிடுவதே பொருத்தமானது.
நீண்ட ஆவணங்களும் விரைவான முதல் பதில்களும்
64K சூழல் நீளத்தில் Tiangai 300-இன் கவனச் செயல்திறன் H200-இன் 1.05 மடங்கை எட்டியதாக நிறுவனத்தின் ஆய்வகம் தெரிவித்தது. மாதிரி தனது உள்ளீட்டின் எந்தப் பகுதிகள் ஒன்றுக்கொன்று தொடர்புடையவை என்பதைக் கண்டறிய உதவும் செயல்முறையே கவனம் (attention). 64K சூழல் நீளம் என்பது மாதிரி சுமார் 64,000 token-களைக் கையாள்கிறது என்பதாகும்.
அதே சூழல் அளவில் GLM-5.3 மாதிரியில், இணையான பயனர் அனுபவத்தைப் பேணியபடி H200 செயல்திறனின் 1.15 மடங்கு செயல்திறனைப் பெற்றதாக Iluvatar CoreX கூறியது. சோதிக்கப்பட்ட நிபுணர் கலவைப் பணிச்சுமையில் இது 15% அதிகரிப்பாகும். ஒவ்வொரு token-க்கும் எல்லா வலைப்பின்னல்களையும் பயன்படுத்துவதற்குப் பதிலாக, தேர்ந்தெடுக்கப்பட்ட சிறப்பு வலைப்பின்னல்களுக்குப் பணியை அனுப்பும் மாதிரியே நிபுணர் கலவை (mixture of experts) ஆகும்.
8K முதல் 128K வரையிலான சூழல்களைக் கொண்ட AI முகவர் பணிச்சுமைகளில், முதல் வெளியீட்டு token வருவதற்கான காத்திருப்பு சுமார் 10% முதல் 30% வரை குறைந்ததாக நிறுவனம் தெரிவித்தது. நீண்ட ஆவணத்தை வாசித்தோ சிக்கலான கோரிக்கையைச் செயலாக்கியோ முடித்த பிறகு, உதவியாளர் பதிலளிக்கத் தொடங்குவதற்காகக் காத்திருப்பவர்களுக்கு இந்த அளவீடு முக்கியமானது.
படம் மற்றும் காணொளி உருவாக்கமும் செயல்விளக்கத்தின் ஒரு பகுதியாக இருந்தன. H200-ஐ ஒப்பிடும்போது பன்மாதிரி உருவாக்கச் செயல்திறன் சுமார் 2% முதல் 5% வரை அதிகரித்ததாக நிறுவனம் தெரிவித்தது. இணையவழித் தேடல், விளம்பரம் மற்றும் பரிந்துரைப் பணிச்சுமைகளில், பரிந்துரை ஊகக்கணிப்புச் செயல்திறன் 21% அதிகமாகவும், இலகு கணக்கீட்டுக்கான தாமதம் 26% குறைவாகவும் இருந்ததாக அது கூறியது.
பயிற்சி முடிவுகளுக்கு வேறொரு Nvidia ஒப்பீடு
சுமார் 32 பில்லியன் அளவுருக்களைக் கொண்ட Qwen3-32B மாதிரியை எட்டு GPU சர்வரில் பயன்படுத்தி பயிற்சிச் செயல்விளக்கம் நடத்தப்பட்டது. வடிவங்களைக் கற்றுக்கொள்ளப் பயிற்சியின்போது மாதிரி சரிசெய்யும் எண் மதிப்புகளே அளவுருக்கள். ஒவ்வொரு அட்டைக்குமான பயனுள்ள செயல்திறன் Nvidia-வின் H100-ஐவிட 1.33 மடங்கை எட்டியதாக Iluvatar CoreX கூறியது.
எனவே, அந்தப் பயிற்சிச் செயல்விளக்கத்தில் ஒப்பீட்டு சிப்பாக H100 பயன்படுத்தப்பட்ட நிலையில், தெரிவிக்கப்பட்ட முன்னிலை 33% ஆகும். நிகழ்வின் பிற பகுதிகளில் வெளியிடப்பட்ட ஊகக்கணிப்பு முடிவுகள் H200-ஐப் பயன்படுத்தின. இந்த எண்களைப் புரிந்துகொள்ள, இரு ஒப்பீட்டு தயாரிப்புகளையும் தனித்தனியாகக் கருதுவது அவசியம்.
பயிற்சி அமைப்பு FP8 துல்லியத்தில் இயங்கியது. எட்டு பிட்களைப் பயன்படுத்தி எண்களைச் சேமிக்கும் FP8, அதிக பிட்களைப் பயன்படுத்தும் வடிவங்களுடன் ஒப்பிடும்போது நகர்த்தவும் செயலாக்கவும் வேண்டிய தரவின் அளவைக் குறைக்கிறது. இந்தக் குறைந்த துல்லியத்திலும் கற்றலின் தரம் பேணப்படுவதை AI பயிற்சி மென்பொருள் கவனமாகக் கையாள வேண்டும்.
முழுச் சுமையில் நீண்ட நேரம் இயங்கும்போது படிநிலை நேர மாறுபாடு 0.43% எனவும், Hopper அடிப்படையிலான ஒப்பீட்டு அமைப்பில் அது 0.76% எனவும் Iluvatar CoreX தெரிவித்தது. மீண்டும் மீண்டும் நடைபெறும் ஒரு வேலையை முடிக்கத் தேவையான நேரமே படிநிலை நேரம். நேரம் மேலும் சீராக இருப்பது, இயங்குபவர்கள் அதிகப் பணிச்சுமையுள்ள அமைப்பு எவ்வளவு வேலையை முடிக்கும் எனத் திட்டமிட உதவும்.
ஜூலை அறிமுகத்திலிருந்து அக்டோபர் செயல்விளக்கம் வரை
2026 ஜூலையில் நடைபெற்ற உலக செயற்கை நுண்ணறிவு மாநாட்டில் Tiangai 300 அதிகாரபூர்வமாக அறிமுகப்படுத்தப்பட்டது. இது நிறுவனத்தின் Tianshu கட்டமைப்பைப் பயன்படுத்துகிறது; புதிய தலைமுறை Tensor Core-களைக் கொண்டுள்ளது; மேலும் 144GB கிராபிக்ஸ் நினைவகத்துடன் குறிப்பிடப்பட்டுள்ளது.
இந்தச் செயலி ஸ்கேலர், வெக்டர், டென்சர் செயல்பாடுகளை ஆதரிக்கிறது. எளிமையாகச் சொன்னால், இவை தனிப்பட்ட எண்கள், எண்களின் குழுக்கள், பெரிய கணித அணிகள் ஆகியவற்றைக் கையாளுகின்றன. ஆதரிக்கப்படும் எண் வடிவங்களில் FP4, FP8, FP16 மற்றும் BF16 அடங்கும். வேகம், நினைவகப் பயன்பாடு, எண் துல்லியம் ஆகியவற்றுக்கு இடையே மென்பொருள் உருவாக்குநர்கள் வெவ்வேறு தேர்வுகளைச் செய்ய இவை வழிவகுக்கின்றன.
நிறுவனம் விவரித்த பொதுவெளி முக்கிய நிகழ்வுகள் பல மாதங்களைக் கடந்து நடந்துள்ளன:
- 2026 ஜூலை: உலக செயற்கை நுண்ணறிவு மாநாட்டில் Tiangai 300 அறிமுகப்படுத்தப்பட்டது.
- 2026 ஜூலை: H200 செயல்திறன் ஒப்பீட்டுக்காகக் குறிப்பிடப்பட்ட மூன்றாம் தரப்புச் சோதனையை Shanghai Electric Group நிறைவு செய்தது.
- அக்டோபர் ஊடக நிகழ்வுக்கு முன்பு: China International Industry Fair-இல் IXL144 ரேக் வடிவமைப்பு காட்சிப்படுத்தப்பட்டது.
- 2026 அக்டோபர் 28: ஷாங்காயில் ஊடகத்தினருக்காக Tiangai 300 வன்பொருளின் நேரடி செயல்விளக்கங்களை Iluvatar CoreX தொடங்கியது.
அக்டோபர் நிகழ்வு, தயாரிப்பு பற்றிய விளக்கத்தை கட்டமைப்பு அறிமுகத்திலிருந்து பெயரிடப்பட்ட பணிச்சுமைகளை இயக்கும் அமைப்புகளுக்கு நகர்த்தியது. நிறுவனத்தின் விளக்கத்தின்படி, தனிப்பட்ட முடுக்கி அட்டைகள் முதல் எட்டு அட்டைகளைக் கொண்ட சர்வர்கள், பெரிய IXL144 அமைப்பு வரை இப்போது பயன்பாட்டு வரம்பு விரிந்துள்ளது.
144 GPU-களை மையமாகக் கொண்ட ரேக்
ஒரே நிலையான ரேக்கில் 144 GPU-களையும் 18 CPU-களையும் IXL144 இணைக்கிறது. மொத்த GPU நினைவகம் சுமார் 10.1TB என Iluvatar CoreX தெரிவித்தது. ஒரே ரேக்கில் வைக்கப்பட்டுள்ள தொழில்துறையின் அதிக அடர்த்தியுள்ள GPU சூப்பர்நோடு எனவும் நிறுவனம் இதை விவரித்தது. பெரிய பணிகளில் இணைந்து செயல்பட, பல செயலிகளை நெருக்கமாக இணைப்பதே சூப்பர்நோடு ஆகும்.
ஒவ்வொரு Tiangai 300-க்கும் 144GB என்றும், ரேக்கின் மொத்தம் 10.1TB என்றும் கூறப்பட்டுள்ள நினைவக விவரங்களுக்கு உள்ளமைவு குறித்த தெளிவான விளக்கம் தேவை. 144 அட்டைகளை 144GB-ஆல் பெருக்கினால், கொள்ளளவைக் கணக்கிடும் முறைகளில் உள்ள வேறுபாடுகளைக் கணக்கில் கொள்ளும் முன்பே, 20,736GB கிடைக்கிறது. அட்டைகளின் உள்ளமைவு என்ன, பணிச்சுமைகளுக்குக் கிடைக்கும் நினைவக அளவு என்ன என்பதை ரேக் விவரம் குறிப்பிட வேண்டும்.
சர்வதேச அளவில் பரவலாகப் பயன்படுத்தப்படும் அமைப்புகளுடன் ஒப்பிடும்போது, ஒரு மில்லியன் பயனுள்ள token-களுக்கான செலவை இந்த அமைப்பு சுமார் 40% குறைக்கக்கூடும் என Iluvatar CoreX மதிப்பிடுகிறது. பயனுள்ள token-கள் என்பது பயனுள்ள வேலையாகக் கணக்கிடப்படும் வெளியீடுகளைக் குறிக்கிறது. AI சேவைகளை விற்கும் இயக்குநர்களுக்கு, வன்பொருள் செலவையும் உற்பத்தியாகும் பயன்படத்தக்க வெளியீட்டின் அளவையும் இந்த அளவீடு இணைக்கிறது.
40% குறைப்பு என்றால், ஒப்பீட்டு அமைப்பில் 100 அலகுச் செலவாகும் வேலைக்கு 60 அலகுகள் செலவாகும். நடைமுறைச் சேமிப்பு, உபகரண விலை, மின்சாரப் பயன்பாடு, மென்பொருள், பணிச்சுமை, GPU-கள் எவ்வளவு சீராகப் பயன்பாட்டில் உள்ளன என்பவற்றைப் பொறுத்தது.
அடுத்த தலைமுறை peer-to-peer இணைப்புப் பொறிக்கான இலக்கையும் நிறுவனம் விவரித்தது: இணைக்கப்பட்ட பரப்புக்குள் ஒற்றைப் பரிமாற்ற நேரத்தை 3 முதல் 5 மைக்ரோவினாடிகளிலிருந்து 1 மைக்ரோவினாடியாகக் குறைப்பது. வெவ்வேறு GPU-களில் ஒரு மாதிரியின் வெவ்வேறு பகுதிகள் இருக்கும்போது, அவை தரவைத் தொடர்ந்து பரிமாறிக்கொள்ள வேண்டியிருக்கும். விரைவான தகவல்தொடர்பு அப்போது உதவியாக இருக்கும்.
வெவ்வேறு சிப்களிடையே AI பணிகளைப் பகிர்தல்
Iluvatar CoreX-இன் பன்முகச் செயலி பயன்பாட்டு அணுகுமுறை, ஊகக்கணிப்பின் வெவ்வேறு பகுதிகளை வெவ்வேறு வகை செயலிகளுக்கு ஒதுக்குகிறது. அதன் AFD பிரிப்பு முறையில், prefill நிலை முழுவதையும், decoding-இன் போது நடைபெறும் கவனக் கணக்கீடுகளையும் Tiangai 300 கையாள்கிறது. கூட்டாளி நிறுவனத்தின் XPU, feed forward நிபுணர் வலைப்பின்னல்களைக் கையாள்கிறது.
XPU என்பது மற்றொரு வகை கணினி முடுக்கிக்கான பொதுவான பெயர். ஒவ்வொரு செயலியும் சிறப்பாகச் செய்யக்கூடிய பணியை அதற்கு வழங்கி, பொதுவான திட்டமிடி முழுப் பணியையும் ஒருங்கிணைப்பதே இதன் அடிப்படைக் கருத்து. மொழி மாதிரியின் கணிதச் செயலாக்கத்தில் மற்றொரு முக்கியப் பகுதியை feed forward வலைப்பின்னல்கள் செய்கின்றன.
ஒருங்கிணைந்த திட்டமிடலின் கீழ் decoding ஊகக்கணிப்புத் தாமதம் 60% குறைந்ததாக நிறுவனம் தெரிவித்தது. இது H200-ஐவிட 5% செயல்திறன் முன்னிலை என்ற முக்கிய முடிவிலிருந்து வேறுபட்ட அமைப்பாகும்; அளவிடப்பட்ட செயல்திறன் கூறும் வேறுபட்டது.
ஒரே வகை செயலியை எல்லாப் பணிகளுக்கும் நம்பியிருப்பதற்குப் பதிலாக, வெவ்வேறு சிப்களைத் திறம்பட ஒழுங்கமைப்பதே எதிர்கால AI கணினி அமைப்புகளின் அடிப்படையாக இருக்கும் என நிறுவனத்தின் AI மற்றும் முடுக்கக் கணினிப் பிரிவுத் தலைவர் Shan Tianyi கூறினார். GPU-களையும் கூட்டாளர் முடுக்கிகளையும் இணைக்கும் ஒரு நடைமுறை அமைப்பாக AFD செயல்விளக்கம் இந்த உத்தியை வெளிப்படுத்துகிறது.
பயன்பாட்டுக்கான நேரத்தைக் குறிவைக்கும் மென்பொருள் கூற்றுகள்
பயன்படுத்தல் மற்றும் மேம்படுத்தலின் சில பகுதிகளைத் தானியக்கமாக்கும் நோக்கிலான “AI-க்கான AI” மென்பொருள் தொகுப்பையும் Iluvatar CoreX அறிமுகப்படுத்தியது. சூழல் அமைக்கும் பணி ஒரு மணிநேரத்திலிருந்து 10 நிமிடங்களாகக் குறைந்ததாகவும், கைமுறைச் செயல்பாடுகளின் எண்ணிக்கை டஜன் கணக்கிலிருந்து ஒன்றாகக் குறைந்ததாகவும் நிறுவனம் கூறியது.
ஒரு பெரிய மாதிரியை மேம்படுத்தும் பணியில், வேலைச் சுழற்சி ஏழு நாட்களிலிருந்து இரண்டு மணி நேரத்துக்கும் குறைவாகக் குறைக்கப்பட்டதாகவும், செயல்திறன் முந்தைய அளவின் கிட்டத்தட்ட இருமடங்கை எட்டியதாகவும் நிறுவனம் தெரிவித்தது. வன்பொருளில் மாதிரிகளைத் திறம்பட இயக்கத் தேவையான பொறியியல் பணிகளைப் பற்றியவை இந்த எடுத்துக்காட்டுகள்.
GPU கணக்கீட்டுச் செயல்முறைகளை உருவாக்கப் பயன்படுத்தப்படும் FlyDSL மொழியுடன் ஆழமான ஒருங்கிணைப்பும் இருப்பதாக நிறுவனம் கூறியது. தொகுப்பாக்க வேகம் 90%-க்கும் மேல் மேம்பட்டதாகவும், முன்பு 10 பேர் ஒரு நாள் முழுவதும் செய்த பணியை ஒருவர் சில மணி நேரங்களில் முடிக்கும் பணிச்சூழல் உருவாக்கப்பட்டதாகவும் அது தெரிவித்தது.
ஒரு செயலிக்கு திறமையான கணித வன்பொருள் மட்டும் போதாது என்பதால் மென்பொருள் ஆதரவு முக்கியமானது. மாதிரிகள், கணித நூலகங்கள், பயன்பாட்டுக் கருவிகள் ஆகியவை ஒன்றாகச் செயல்பட வேண்டும். புதிய GPU-வைச் செயல்படும் சேவையாக மாற்றுவதற்கு வாடிக்கையாளர்களுக்கு எவ்வளவு பொறியியல் உழைப்பு தேவைப்படலாம் என்பதை மென்பொருள் செயல்விளக்கங்கள் எடுத்துரைக்கின்றன.
ரோபோக்களுக்கான முன்மொழிவை விரிவாக்கும் TY1200
AI கணினிகள் மற்றும் உடல்சார் உலகை உணர்ந்து செயல்படும் ரோபோக்கள் உள்ளிட்ட உடல்சார் நுண்ணறிவுக்கென வடிவமைக்கப்பட்ட தனிச் செயலியான Tongyang TY1200-வும் ஷாங்காய் நிகழ்வில் காட்சிப்படுத்தப்பட்டது. இதன் குறித்த அடர்த்தி கணக்கீட்டுத் திறன் 300 TOPS, அதாவது வினாடிக்கு 300 டிரில்லியன் செயல்பாடுகள் ஆகும். பூஜ்ஜிய மதிப்புகள் தொடர்பான கணக்கீடுகளைத் தவிர்ப்பதைச் சாராமல் கணக்கிடப்படும் பணிகளே அடர்த்திக் கணக்கீடு ஆகும்.
Qwen3.8-27B மற்றும் Qwen3.6-35B-A3B சோதனைகளில் TY1200, Nvidia Thor T5000 செயல்திறனின் 1.2 மடங்கை எட்டியதாக Iluvatar CoreX கூறியது. உடல்சார் AI சூழல்களில் Cosmos-R2-2B மற்றும் Cosmos-R2-8B மாதிரிகளுக்கு, Thor T5000 ஒப்பீட்டு அளவின் முறையே 158% மற்றும் 180% செயல்திறன் கிடைத்ததாகவும் தெரிவித்தது.
MuJoCo-Warp-ஐப் பயன்படுத்தி GPU முடுக்கம் கொண்ட இயற்பியல் உருவகப்படுத்தலை TY1200 இயக்க முடியும் என்றும் நிறுவனம் கூறியது. இதன் மூலம் ரோபோ மேம்பாட்டு அமைப்பு இயக்கங்களை உருவகப்படுத்தவும், கட்டுப்பாட்டுக் கொள்கையைப் பயிற்றுவிக்கவும், செயல்களை உள்ளூரிலேயே சரிபார்க்கவும் முடியும். ரோபோ எவ்வாறு நகர வேண்டும் என முடிவெடுக்க அது பயன்படுத்தும் கற்றுக்கொண்ட வழிமுறைகளின் தொகுப்பே கட்டுப்பாட்டுக் கொள்கை.
மருத்துவச் சந்திப்புகளின்போது மக்களுக்கு உதவும் ரோபோக்கள், தொழில்துறைப் பார்வை, வருகையாளர்களுக்கு வழிகாட்டுதல் ஆகியவை குறிப்பிடப்பட்ட பயன்பாடுகளில் அடங்கும். திட்டமிடப்பட்டுள்ள அடுத்த பதிப்பான TY2000-க்கான கணக்கீட்டு இலக்கு 600T எனக் குறிப்பிடப்பட்டுள்ளது. இந்தத் தயாரிப்புகள், பெரிய AI சர்வர்களிலிருந்து பயனர்களுக்கும் இயந்திரங்களுக்கும் அருகில் இயங்கும் உபகரணங்கள் வரை நிறுவனத்தின் உத்தியை விரிவாக்குகின்றன.
முக்கிய அம்சங்கள்
- 2026 அக்டோபர் 28 அன்று ஷாங்காயில் Tiangai 300 வன்பொருளை Iluvatar CoreX செயல்விளக்கம் செய்தது.
- ஒவ்வொரு அட்டைக்குமான செயல்திறன் Nvidia H200-இன் 1.05 மடங்குக்குச் சமம் என Shanghai Electric Group நடத்திய சோதனையை நிறுவனம் மேற்கோள் காட்டியது.
- எட்டு GPU-களைக் கொண்ட Qwen3-32B பயிற்சிச் செயல்விளக்கத்தில், FP8 துல்லியத்தில் ஒவ்வொரு அட்டைக்குமான H100 செயல்திறனின் 1.33 மடங்கு கிடைத்ததாகத் தெரிவிக்கப்பட்டது.
- முக்கிய மூன்றாம் தரப்புச் செயல்திறன் சோதனையின் விரிவான முறை வெளியிடப்படவில்லை.
- IXL144 ரேக்கில் 144 GPU-களும் 18 CPU-களும் உள்ளன. ஒரு மில்லியன் பயனுள்ள token-களுக்கான செலவு 40% குறையும் எனக் கூறப்பட்டுள்ளது.
- GPU-களுக்கும் XPU-களுக்கும் இடையே பணிகளைப் பகிரும் தனி அமைப்பில் decoding தாமதம் 60% குறைந்ததாகத் தெரிவிக்கப்பட்டது.
- மென்பொருள் தானியக்கமாக்கல், உள்ளூர் AI, ரோபோ உருவகப்படுத்தலில் TY1200-இன் பயன்பாடுகள் ஆகியவற்றையும் நிகழ்வு உள்ளடக்கியது.